Curso: Machine Learning · Profesor: Lihki Rubio Ortega Grupo: Yuryen Rollo, Betzaida Ruiz
En este trabajo nos preguntamos si es posible anticipar, con un día de antelación, la velocidad del viento que medirá una estación meteorológica del Caribe colombiano. Para responderlo usamos las mediciones horarias que el IDEAM publica en el Portal Nacional de Datos Abiertos para 76 estaciones de siete departamentos entre 2020 y 2025. Primero describimos los datos y revisamos su calidad; después analizamos su comportamiento en el tiempo y en el espacio; y por último ajustamos un modelo base, un SVR lineal, que comparamos con referencias simples como repetir el valor de hoy.
Reproducibilidad. El notebook trabaja sobre un panel ya procesado (panel_multivariado.csv), que se
obtiene a partir de los 24 CSV originales del IDEAM con los scripts de la carpeta scripts/. Los scripts
escriben sus resultados en la carpeta desde la que se ejecutan, y el notebook los lee de la carpeta
hermana ../ideam_viento/. Desde la carpeta de este repositorio:
mkdir ../ideam_viento
cd ../ideam_viento
python ../entregable1/scripts/procesar_todo.py "<carpeta con los CSV descargados>"            # limpieza original
python ../entregable1/scripts/procesar_todo.py "<carpeta con los CSV descargados>" --causal   # limpieza causal (sección 3) y sensibilidad de 3.6
python ../entregable1/scripts/verificar_conteo.py "<carpeta con los CSV descargados>"
procesar_todo.py ejecuta procesar_variable.py (limpieza de cada variable) y unir_panel.py (unión
con el catálogo de estaciones) y escribe el panel y los reportes de auditoría que usa la sección 1.6. Para
leer los datos de otra carpeta basta con definir la variable de entorno DATOS_PANEL antes de abrir el
notebook. La tabla de umbrales de la sección 1.6 se genera con
python scripts/revisar_umbral.py "<carpeta VELOCIDAD DEL VIENTO>" desde la carpeta del repositorio.
Todas las semillas aleatorias están fijadas (42) y las versiones de las librerías están en
requirements.txt.
import json
import os
import re
import unicodedata
import warnings
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats
from matplotlib.cm import ScalarMappable
from matplotlib.collections import PolyCollection
from matplotlib.colors import Normalize
from scipy.spatial import ConvexHull
from sklearn.cluster import DBSCAN, KMeans
from sklearn.compose import TransformedTargetRegressor
from sklearn.decomposition import PCA
from sklearn.dummy import DummyRegressor
from sklearn.ensemble import IsolationForest
from sklearn.feature_selection import mutual_info_regression
from sklearn.linear_model import LinearRegression
from sklearn.metrics import (mean_absolute_error, mean_absolute_percentage_error, mean_squared_error,
                             r2_score, silhouette_score)
from sklearn.model_selection import GroupKFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import LinearSVR
from statsmodels.stats.diagnostic import het_breuschpagan
from statsmodels.stats.multitest import multipletests
from statsmodels.stats.outliers_influence import variance_inflation_factor
from statsmodels.tsa.seasonal import STL
from statsmodels.tsa.stattools import acf, adfuller, kpss, pacf
from IPython.display import display
warnings.filterwarnings("ignore")
SEED = 42
np.random.seed(SEED)
RNG = np.random.default_rng(SEED)
sns.set_theme(style="whitegrid", context="notebook")
plt.rcParams["figure.dpi"] = 110
pd.set_option("display.float_format", "{:.3f}".format)
pd.set_option("display.max_columns", 30)

# carpeta con el panel y las auditorías generados por scripts/procesar_todo.py; por defecto, la carpeta
# hermana ideam_viento/ (ver "Reproducibilidad"); se puede cambiar con la variable de entorno DATOS_PANEL
DATOS = Path(os.environ.get("DATOS_PANEL", "../ideam_viento"))
TEST_INI = pd.Timestamp("2025-01-01")  # conjunto de prueba reservado: todo 2025
H = 24                                 # horizonte de pronóstico (horas)
K_VECINOS = 4                          # vecinos para el rezago espacial y las matrices de pesos


def muestra(x, n):
    """Muestra aleatoria reproducible de hasta n filas (todas si hay menos)."""
    return x.sample(min(n, len(x)), random_state=SEED)


def haversine_matriz(lat, lon):
    la, lo = np.deg2rad(lat), np.deg2rad(lon)
    a = np.sin((la[:, None] - la) / 2) ** 2 + np.cos(la[:, None]) * np.cos(la) * np.sin((lo[:, None] - lo) / 2) ** 2
    return 2 * 6371 * np.arcsin(np.sqrt(a))


def pesos_knn(dist, k=K_VECINOS):
    d = dist.copy()
    np.fill_diagonal(d, np.inf)
    W = np.zeros_like(d)
    idx = np.argsort(d, axis=1)[:, :k]
    W[np.arange(len(d))[:, None], idx] = 1 / k
    return W


def moran(z, W):
    z = np.asarray(z, float) - np.mean(z)
    return len(z) / W.sum() * (z @ W @ z) / (z @ z)


# ---------- mapa base: límites departamentales (geoBoundaries, OpenStreetMap, licencia ODbL 1.0) ----------
def _normalizar(t):
    return unicodedata.normalize("NFKD", t).encode("ascii", "ignore").decode().upper()


def _anillos(feature):
    g = feature["geometry"]
    partes = [g["coordinates"]] if g["type"] == "Polygon" else g["coordinates"]
    return [np.array(parte[0]) for parte in partes]  # anillo exterior de cada polígono


GEO = json.load(open("mapas/colombia_departamentos.geojson", encoding="utf-8"))
POLIGONOS = {_normalizar(f["properties"]["shapeName"]): _anillos(f) for f in GEO["features"]}
CARIBE = ["ATLANTICO", "BOLIVAR", "CESAR", "CORDOBA", "LA GUAJIRA", "MAGDALENA", "SUCRE"]


def mapa_base(ax, valores=None, cmap="Blues", etiqueta=None, nombres=False):
    """Dibuja los departamentos; con `valores` (dict depto → número) dibuja una coropleta."""
    norma = Normalize(min(valores.values()), max(valores.values())) if valores else None
    for d, anillos in POLIGONOS.items():
        caribe = d in CARIBE
        if valores and d in valores:
            color = plt.get_cmap(cmap)(norma(valores[d]))
        else:
            color = "#ececec" if caribe else "#f8f8f8"
        ax.add_collection(PolyCollection(anillos, facecolor=color, edgecolor="gray",
                                         linewidth=.7 if caribe else .3, zorder=0))
        if nombres and caribe:
            x, y = np.concatenate(anillos).mean(axis=0)
            ax.annotate(d.title(), (x, y), fontsize=7, color="dimgray", ha="center", zorder=3)
    ax.set_xlim(-76.7, -70.9); ax.set_ylim(7.2, 12.7)
    ax.set_aspect(1 / np.cos(np.deg2rad(10)))  # corrige la escala de la longitud a 10 °N
    ax.set_facecolor("white")  # fuera de Colombia (mar y Venezuela) queda en blanco: el archivo solo trae Colombia
    ax.grid(False)
    if valores:
        plt.colorbar(ScalarMappable(norm=norma, cmap=cmap), ax=ax, label=etiqueta, shrink=.8)


def moran_perm(z, W, n=999, rng=RNG):
    I = moran(z, W)
    sim = np.array([moran(rng.permutation(z), W) for _ in range(n)])
    return I, (np.sum(sim >= I) + 1) / (n + 1)
1. Base de datos
1.1 Problema de investigación
Queremos saber si la velocidad del viento de mañana, a una hora determinada, se puede predecir en una estación del Caribe colombiano usando únicamente lo que se ha medido hasta hoy. Es un problema de regresión sobre un panel espacio-temporal: cada observación es una estación en una hora, las estaciones tienen coordenadas y sus mediciones forman series de tiempo, así que el análisis tiene que tener en cuenta tanto la dependencia temporal como la espacial (secciones 2.6 a 2.8).
Conviene precisar qué significa “24 horas”. Cada registro horario t es el promedio de la hora que empieza
en t; por ejemplo, el valor de las 10:00 resume lo medido entre las 10:00 y las 10:59. Como ese promedio solo
existe cuando la hora termina, el pronóstico se emite en t + 1 h, con la hora t como la última completa. La
variable objetivo es VViento(t + 24 h): la velocidad media de la hora que empieza 24 h después de la
última hora observada. Visto desde el momento en que se emite el pronóstico, la hora objetivo empieza 23 h
después y termina 24 h después; en el resto del documento hablamos de horizonte de 24 h en ese sentido.
Un pronóstico así tiene usos concretos: planear la operación del día siguiente en los parques eólicos de La Guajira, en los puertos de Barranquilla, Cartagena y Santa Marta, y en los aeropuertos de la región.
1.2 Selección del conjunto de datos
Antes de llegar a este conjunto evaluamos otras dos fuentes:
| Dataset | Resultado | Decisión |
|---|---|---|
| NASA POWER (reanálisis MERRA-2, diario, 42 puntos de malla) | Es un modelo de reanálisis con celdas de ≈ 50 km, no una medición: no responde la pregunta sobre el viento medido en cada sitio. Además, el pronóstico diario resultó casi trivial (persistencia R² = 0.94) y el archivo de 2021 estaba desalineado | Descartado |
| Mendeley (estaciones in situ, diario) | Sus estaciones de Atlántico no aparecen en el catálogo oficial DHIME del IDEAM: no es verificable | Descartado |
| IDEAM horario (datos.gov.co) | Mediciones in situ de la fuente oficial, con resolución horaria (permite estudiar el ciclo diario, clave en la costa), 4 variables y 76 estaciones con coordenadas | Seleccionado |
Nos quedamos con el IDEAM porque es el que corresponde a la pregunta que queremos responder: viento medido en sitios concretos y con resolución horaria, que es la escala en la que se manifiesta la brisa costera. Al ser la fuente oficial, además, cualquiera puede verificar y repetir la descarga.
1.3 Fuente y licencia
| Conjunto (IDEAM, datos.gov.co) | Enlace | Resolución original |
|---|---|---|
| Velocidad del Viento | https:// | 10 min / 2 min |
| Dirección del Viento | https:// | 10 min / 2 min |
| Temperatura Ambiente del Aire | https:// | 1 h |
| Presión Atmosférica | https:// | 1 h |
| Catálogo Nacional de Estaciones del IDEAM | https:// | — |
Descargamos los datos de los departamentos de Atlántico, Bolívar, Cesar, Córdoba, La Guajira, Magdalena y
Sucre para los años 2020 a 2025, en un archivo CSV por variable y año (24 archivos, unos 6.4 GB). Los cinco
conjuntos se publican bajo la licencia Creative Commons Atribución-CompartirIgual 4.0 Internacional
(CC BY-SA 4.0), con atribución al Instituto de Hidrología, Meteorología y Estudios Ambientales (IDEAM)
(https://
La propia ficha del portal advierte que “los datos … no han sido validados por el IDEAM”: son lecturas crudas de sensores automáticos. Por eso dedicamos la sección 1.6 a revisar su calidad.
P = pd.read_csv(DATOS / "panel_multivariado.csv", dtype={"CodigoEstacion": str}, parse_dates=["hora"])
P = P.rename(columns={"CodigoEstacion": "est"})
P["anio"] = P.hora.dt.year
print(f"Panel estación-hora: {len(P):,} filas | {P.est.nunique()} estaciones | "
      f"{P.hora.min():%Y-%m-%d} a {P.hora.max():%Y-%m-%d}")
P.head()
Panel estación-hora: 1,302,607 filas | 76 estaciones | 2020-01-01 a 2025-12-31
1.4 Diccionario de variables
dicc = pd.DataFrame([
    ("est", "categórica (ID)", "—", "Código de la estación en el catálogo del IDEAM (10 dígitos)"),
    ("nombre, depto, municipio", "categórica", "—", "Nombre y ubicación administrativa de la estación"),
    ("lat, lon", "numérica continua", "grados (EPSG:4326)", "Coordenadas de la estación"),
    ("hora", "fecha-hora", "hora local", "Inicio de la hora de agregación"),
    ("vel", "numérica continua", "m/s", "Velocidad media del viento en la hora (objetivo a t+24 h)"),
    ("dir", "numérica circular", "grados (0–360)", "Dirección de la que sopla el viento, media vectorial de la hora"),
    ("dir_sin, dir_cos", "numérica continua", "adimensional",
     "Seno y coseno medios de la dirección en la hora: componentes del vector medio de dirección. "
     "No es unitario: su norma es dir_constancia"),
    ("dir_constancia", "numérica continua", "0–1", "Longitud del vector medio: 1 = dirección fija en la hora"),
    ("temp", "numérica continua", "°C", "Temperatura del aire a 2 m"),
    ("pres", "numérica continua", "hPa", "Presión atmosférica en la estación (no reducida al nivel del mar)"),
    ("categoria", "categórica", "—", "Categoría de la estación según el catálogo"),
    ("altitud", "numérica continua", "m s. n. m.", "Altitud de la estación según el catálogo"),
], columns=["variable", "tipo", "unidad", "significado"])
dicc["% de filas del panel con dato"] = [100.0, 100.0, 100.0, 100.0,
                                         *(P[["vel", "dir", "dir_sin", "dir_constancia", "temp", "pres",
                                              "categoria", "altitud"]].notna().mean() * 100).round(1)]
diccEl panel solo guarda las horas con una velocidad válida, porque es la variable que queremos predecir; por
eso la velocidad aparece en el 100 % de las filas. Eso no quiere decir que no haya huecos en el tiempo (los
analizamos en la sección 2.6.1), y los porcentajes de las demás variables se calculan sobre esas mismas filas.
1.5 Estructura y tamaño de la muestra
La unidad de observación es la estación-hora. Las lecturas originales, tomadas cada 10 minutos (o cada 2 en algunos sensores), se promedian por hora; la dirección se promedia como un vector, para que 359° y 1° den 0° y no 180°. El resultado es un panel espacio-temporal: varias estaciones con coordenadas, observadas cada hora.
completas = P[["vel", "dir", "temp", "pres"]].notna().all(axis=1)
por_anio = pd.DataFrame({
    "estación-horas": P.groupby("anio").size(),
    "con las 4 variables": completas.groupby(P.anio).sum(),
    "estaciones": P.groupby("anio").est.nunique(),
    "estaciones con las 4": P[completas].groupby("anio").est.nunique(),
})
por_anio.loc["total"] = [len(P), completas.sum(), P.est.nunique(), P[completas].est.nunique()]
n_pred = 26  # predictoras del modelo final (sección 2.9)
print(f"Filas con las 4 variables: {completas.sum():,} | predictoras del modelo: {n_pred} | "
      f"n/p = {completas.sum() / n_pred:,.0f}")
print(f"Rango de la variable objetivo: {P.vel.min():.2f} a {P.vel.max():.2f} m/s")
por_anio
Filas con las 4 variables: 961,860 | predictoras del modelo: 26 | n/p = 36,995
Rango de la variable objetivo: 0.00 a 21.07 m/s
El panel tiene 76 estaciones con velocidad; 63 de ellas tienen en algún momento las cuatro variables, y el conjunto que usamos para modelar (casos completos, sección 2.0) queda en 62. Aunque las filas se cuentan por cientos de miles, la cantidad de información independiente es mucho menor: dentro de cada estación las horas consecutivas se parecen mucho (sección 2.6), y las estaciones cercanas también se parecen entre sí (sección 2.7). Por eso más adelante validamos por periodos y por estación, y no con particiones al azar.
1.6 Calidad de datos
Auditamos los 24 archivos crudos; el detalle por variable y año está en ideam_viento/reportes/. Este es
el resumen:
filas = []
for f in sorted((DATOS / "reportes").glob("*.txt")):
    if "_causal" in f.stem:  # los reportes de la limpieza causal (y su sensibilidad) no son de la depuración original
        continue
    var, anio = f.stem.split("_")
    t = f.read_text(encoding="utf-8")
    num = lambda patron: int(re.search(patron, t).group(1).replace(",", "")) if re.search(patron, t) else 0
    filas.append({"variable": var, "año": int(anio),
                  "filas crudas": num(r"Filas: ([\d,]+)"),
                  "fuera del Caribe continental": num(r"descartadas\): ([\d,]+)"),
                  "duplicadas": num(r"instante: ([\d,]+)"),
                  "duplicadas con valores distintos": num(r"valores distintos: ([\d,]+)"),
                  "fuera de rango físico": num(r"Lecturas fuera de \[[^\]]+\] \S+: ([\d,]+)"),
                  "pegadas o con picos": num(r"enmascaradas\): ([\d,]+)")})
calidad = pd.DataFrame(filas)
resumen_calidad = calidad.groupby("variable").sum(numeric_only=True).drop(columns="año")
resumen_calidad.loc["total"] = resumen_calidad.sum()
resumen_calidadaud = pd.concat([pd.read_csv(DATOS / f"auditoria_{v}.csv", dtype={"CodigoEstacion": str}).assign(variable=v)
for v in ["velocidad", "direccion", "temperatura", "presion"]])
excl = aud[aud.excluida][["variable", "CodigoEstacion", "NombreEstacion", "anio", "frac_fuera", "max_v", "motivo"]]
print(f"Estación-año excluidas por sensor defectuoso: {len(excl)}")
lect_total = aud.lecturas.sum()
pegadas = aud.frac_pegado * aud.lecturas
retro = pd.DataFrame({
"lecturas": [aud[aud.excluida].lecturas.sum(), pegadas.sum(), pegadas[aud.excluida].sum()],
}, index=["en estación-años excluidas (proporción anual de anomalías)",
"en tramos pegados o picos de presión (tramo completo / mediana anual)",
"contadas en ambos grupos (pegadas dentro de estación-años excluidos)"])
retro.loc["unión sin doble conteo"] = retro.lecturas.iloc[0] + retro.lecturas.iloc[1] - retro.lecturas.iloc[2]
retro["% de las lecturas auditadas"] = 100 * retro.lecturas / lect_total
print(f"Lecturas auditadas (después de quitar duplicados y filas fuera del Caribe): {lect_total:,.0f}")
display(retro.round(3))
altas = aud[aud.variable == "velocidad"].assign(n_fuera=lambda d: d.frac_fuera * d.lecturas)
top2 = altas.groupby("NombreEstacion").n_fuera.sum().nlargest(2)
print(f"Lecturas de velocidad fuera de `[0, 25] m/s`: {altas.n_fuera.sum():,.0f}; "
f"{100 * top2.sum() / altas.n_fuera.sum():.0f} % vienen de {', '.join(top2.index.str.strip())}")
umbral = pd.read_csv("resultados/umbral_velocidad.csv") # generado por scripts/revisar_umbral.py con los CSV crudos
print("Lecturas crudas de velocidad que eliminaría cada umbral (revisión sobre los archivos originales):")
display(umbral.set_index(["umbral (m/s)", "estaciones"]))
excl.sort_values(["variable", "anio"])Estación-año excluidas por sensor defectuoso: 12
Lecturas auditadas (después de quitar duplicados y filas fuera del Caribe): 25,577,649
Lecturas de velocidad fuera de `[0, 25] m/s`: 6,621; 95 % vienen de GALERAZAMBA  - AUT, MONGUI
Lecturas crudas de velocidad que eliminaría cada umbral (revisión sobre los archivos originales):
Las reglas de limpieza que aplicamos (en procesar_variable.py) son las siguientes:
| Problema | Regla |
|---|---|
| Duplicados de descarga (2024–2025) | Conservamos la primera lectura de cada estación, sensor e instante. En el 99.96 % de los duplicados las lecturas son idénticas; solo 1 236 instantes (de 30 millones de lecturas) tienen valores distintos |
| Valores fuera del rango de control | → NaN: velocidad [0, 25] m/s, temperatura [3, 45] °C, presión [500, 1100] hPa. Son umbrales de control de calidad pensados para esta red, no límites físicos universales (ver la justificación más abajo) |
| Sensor defectuoso | Estación-año excluida si > 0.5 % de lecturas fuera de rango (en temperatura, solo lecturas > 45 °C) |
| Sensor pegado | Mismo valor ≠ 0 durante ≥ 6 h (12 h en presión), o 0 durante ≥ 24 h → NaN |
| Picos de presión | A más de 30 hPa de la mediana de su estación-año → NaN |
| Presión incompatible con la altitud | Mediana a > 50 hPa de la presión estándar para la altitud del catálogo → estación-año descartada |
| Horas incompletas | Una hora es válida si tiene al menos el 50 % de las lecturas esperadas |
Los archivos los fuimos descargando y revisando por etapas, de modo que cada umbral se fijó conociendo solo una parte de los años. Lo resumimos en la tabla siguiente, porque importa saber si alguno se eligió mirando el periodo que después usamos como prueba (2025):
| Umbral | Datos conocidos al fijarlo | ¿Se conocía 2025? |
|---|---|---|
Velocidad: rango [0, 25] m/s, 0.5 % para sensor defectuoso, tramo pegado 6 h (0 durante 24 h) | Solo 2020 | No |
| Dirección: rango [0, 360]°, mismos plazos que la velocidad | 2020–2021 | No |
Presión: rango [500, 1100] hPa, picos a > 30 hPa, tramo pegado 12 h, 50 hPa frente a la altitud | 2020–2023 | No |
Temperatura: rango [3, 45] °C y tramo pegado 6 h | 2020–2022 | No |
Temperatura: el criterio de sensor defectuoso cuenta solo lecturas > 45 °C (los 0 °C sueltos solo se enmascaran) | 2020–2025 | Sí, pero solo se usa en la depuración del análisis exploratorio |
Hora válida con ≥ 50 % de lecturas; ventana de 30 días y mínimo de 100 lecturas (limpieza causal, sección 3) | Fijados a priori, sin ajustarlos a los resultados | No |
El único criterio que fijamos después de ver 2025 es el de sensor defectuoso de la temperatura, y solo
interviene en la depuración que usa el análisis exploratorio. Para el modelado (sección 3) usamos el
criterio general, fijado antes (cualquier lectura fuera de [3, 45] °C cuenta), y en la sección 3.6
comprobamos que con el otro criterio el resultado prácticamente no cambia.
Algunos umbrales se definieron con datos de 2020–2023; por ello, reservamos 2024 para seleccionar la configuración del modelo, mediante una validación cruzada de cuatro pliegues dentro de ese año (sección 3.1), un año que, igual que 2025, no se usó para fijar ningún umbral. Los pliegues de 2021 a 2023 aparecen solo como referencia, y la curva de aprendizaje también se valida en 2024.
Para justificar los umbrales no basta con mirar los datos ya limpios, así que revisamos directamente en los
CSV crudos las lecturas que cada umbral elimina (scripts/revisar_umbral.py, tabla de la celda siguiente):
Casi todas las lecturas de velocidad por encima de
25 m/svienen de dos sensores con fallas evidentes, Galerazamba y Mongui, que además presentan saltos bruscos y meses enteros marcando 0.En el resto de las estaciones, el
93 %de las lecturas eliminadas tiene la lectura anterior y la siguiente a no más de dos intervalos de muestreo, y el59 %son picos aislados: superan en más de15 m/sa la mediana de esas dos vecinas. Un salto de ese tamaño que aparece y desaparece en pocos minutos apunta a una falla del sensor, aunque no lo prueba; el resto de las lecturas no lo pudimos clasificar con certeza.Entre un umbral de 25 y uno de
30 m/sla diferencia es de unas 70 lecturas crudas fuera de los sensores dañados. No evaluamos cómo cambiarían el panel y las métricas con otro umbral.En temperatura, las lecturas por encima de
45 °Cse concentran en sensores que repiten exactamente el mismo valor máximo,50.0 °C. Eso parece el tope del instrumento más que una temperatura real, pero no pudimos confirmarlo con la ficha técnica, así que lo tratamos como un supuesto.
La presión ofrece una comprobación adicional: la medida coincide con la esperada para la altitud del
catálogo (atmósfera estándar) con un error mediano de unos 3 hPa, lo que respalda tanto los datos como su
conversión (los valores vienen escritos como "1.003,4"). Usamos esa misma relación para descartar una
estación-año (El Guamo 2021, con 609 hPa a 75 m de altitud), así que para ella la comprobación no es
independiente, pero sí lo es para las otras 280 estación-años.
Varias de estas reglas miran la estación-año completa: la mediana anual para detectar picos de presión, la proporción anual de lecturas anómalas para excluir un sensor, la detección del tramo pegado completo (que borra sus lecturas desde el inicio), la frecuencia de muestreo estimada con todo el archivo y la elección del sensor con más horas en el año. Es un control de calidad razonable para un archivo histórico, pero no reproduce lo que se sabría en el momento de pronosticar. La celda siguiente cuantifica cuántas lecturas afectan las dos reglas medibles (exclusión de estación-años y tramos pegados o picos); la elección del sensor y la frecuencia de muestreo no se pueden medir de la misma forma. Esta depuración la usamos solo para el análisis exploratorio. Para el modelado reconstruimos el procesamiento desde los CSV originales con reglas causales, en las que cada lectura se limpia únicamente con información anterior a ella (sección 3), y en la sección 3.6 comparamos los dos procesamientos.
Casi-duplicados. Además de los duplicados exactos, buscamos estaciones con las mismas coordenadas, que podrían ser la misma serie registrada con dos códigos distintos.
coord_est = P.groupby("est")[["lat", "lon"]].median().round(4)
grupos_coord = coord_est[coord_est.duplicated(["lat", "lon"], keep=False)].groupby(["lat", "lon"]).groups
for (la_, lo_), ests_ in grupos_coord.items():
    ests_ = list(ests_)
    nombres_ = P[P.est.isin(ests_)].groupby("est").nombre.first()
    ancho_ = P[P.est.isin(ests_)].pivot(index="hora", columns="est", values="vel")
    comunes = ancho_.dropna()
    r_ = comunes.corr().iloc[0, 1] if len(comunes) > 24 else np.nan
    print(f"Coordenadas ({la_}, {lo_}): {', '.join(nombres_.str.strip() + ' [' + nombres_.index + ']')}")
    print(f"  horas con dato: {ancho_.notna().sum().to_dict()} | horas en común: {len(comunes)} | "
          f"correlación en horas comunes: {r_:.2f}" if len(comunes) > 24 else
          f"  horas con dato: {ancho_.notna().sum().to_dict()} | no comparten horas: se registraron en periodos distintos")
Coordenadas (9.3164, -75.3875): UNISUCRE [0025025270], PUERTA ROJA - AUT [0025025350]
horas con dato: {'0025025270': 17286, '0025025350': 6013} | no comparten horas: se registraron en periodos distintos
1.6.1 Valores faltantes: patrón y mecanismo
P["mes"] = P.hora.dt.to_period("M")
fig, axs = plt.subplots(1, 3, figsize=(16, 6), sharey=True)
orden = P.groupby("est").vel.size().sort_values(ascending=False).index
for ax, v in zip(axs, ["dir", "temp", "pres"]):
    m = P.groupby(["est", "mes"])[v].apply(lambda s: s.notna().mean()).unstack().reindex(orden)
    sns.heatmap(m, ax=ax, cmap="viridis", vmin=0, vmax=1, cbar=ax is axs[-1],
                cbar_kws={"label": "fracción de horas con dato"}, xticklabels=12, yticklabels=False)
    ax.set(title=f"{v}: disponibilidad (estación × mes)", xlabel="mes", ylabel="estaciones" if ax is axs[0] else "")
fig.tight_layout(); plt.show()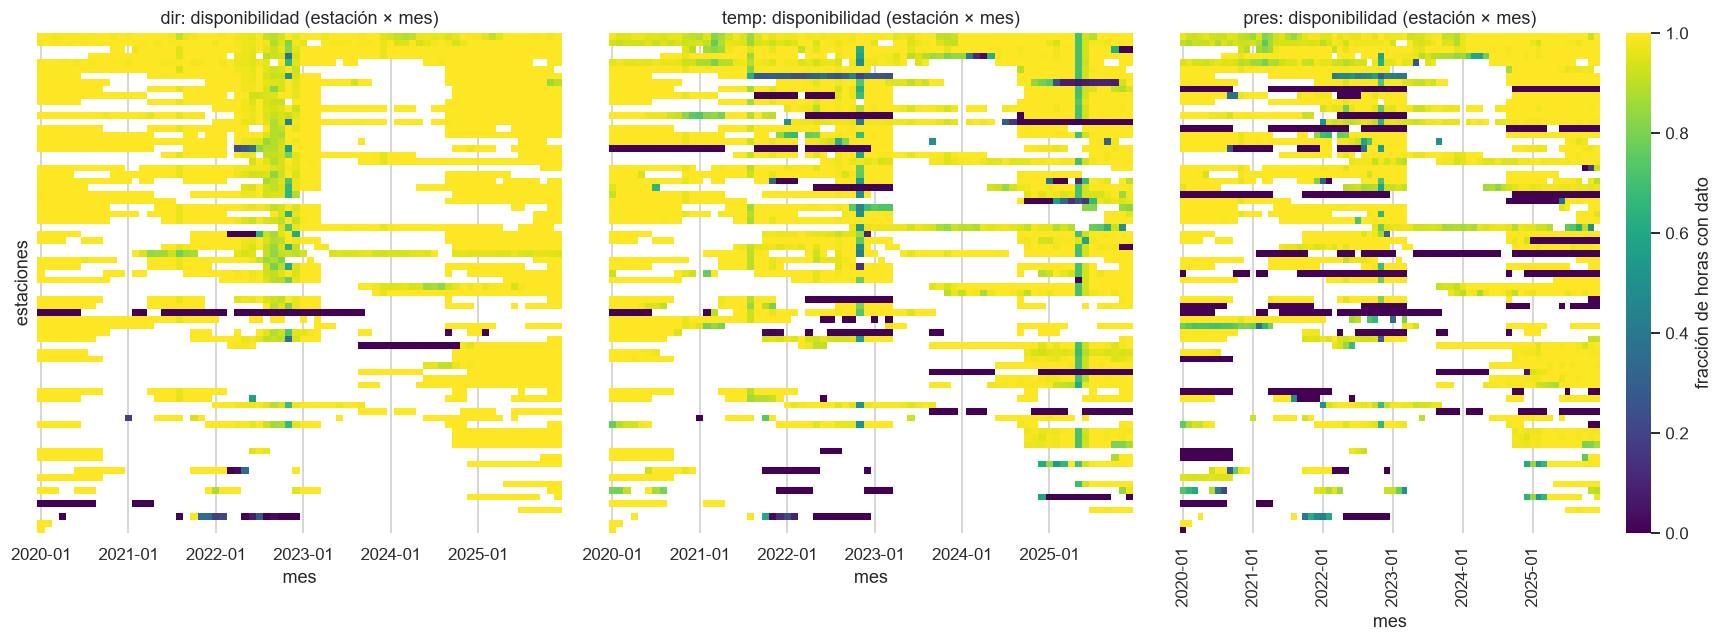
mec = []
for v in ["dir", "temp", "pres"]:
    falta = P[v].isna()
    por_est = falta.groupby(P.est).mean()
    estructural = P.est.map(por_est).gt(0.95) & falta  # faltantes en estaciones sin ese sensor
    ks = stats.ks_2samp(muestra(P.vel[falta], 20000), muestra(P.vel[~falta], 20000))
    mec.append({"variable": v, "% faltante": 100 * falta.mean(),
                "% de faltantes en estaciones sin el sensor (>95 % faltante)": 100 * estructural.sum() / falta.sum(),
                "vel media si falta": P.vel[falta].mean(), "vel media si hay dato": P.vel[~falta].mean(),
                "KS (vel | falta vs. no falta)": ks.statistic, "p": ks.pvalue})
pd.DataFrame(mec).set_index("variable")Los faltantes no son completamente aleatorios (MCAR). En buena parte son estructurales: el 68 % de los
faltantes de presión, el 50 % de los de dirección y el 19 % de los de temperatura corresponden a estaciones
que prácticamente no tienen ese sensor, y en el mapa de calor aparecen como franjas horizontales completas.
Además, la distribución de la velocidad cambia según falte o no la otra variable (la prueba KS es
significativa), sobre todo con la dirección: cuando falta, la velocidad media es de 1.32 m/s frente a
1.95 m/s, porque con calma la veleta no registra una dirección definida.
Lo más plausible es un mecanismo MAR, en el que la ausencia depende de variables que sí observamos (la
estación y la velocidad). No podemos descartar que también dependa del propio valor faltante (MNAR); por
ejemplo, un termómetro podría fallar más con calor extremo. La prueba de Little no es adecuada para series
tan autocorrelacionadas, y con tantos datos la prueba KS siempre resulta significativa, así que nos fijamos
en el tamaño del efecto: pequeño para la temperatura (0.04) y la presión (0.07) y moderado para la dirección
(0.25). Con esto decidimos trabajar con casos completos, entendiendo que el modelo describe las estaciones y
horas que tienen las cuatro variables (sección 2.9).
1.6.2 Sesgos de muestreo y representatividad
est = P.groupby("est").agg(nombre=("nombre", "first"), depto=("depto", "first"), lat=("lat", "median"),
                           lon=("lon", "median"), altitud=("altitud", "first"), categoria=("categoria", "first"),
                           horas=("vel", "size"), vel_media=("vel", "mean"))
fig, axs = plt.subplots(1, 2, figsize=(14, 4))
est.depto.value_counts().plot.bar(ax=axs[0], color="steelblue")
axs[0].set(title="Estaciones por departamento", ylabel="estaciones")
est.altitud.plot.hist(bins=30, ax=axs[1], color="steelblue")
axs[1].set(title="Altitud de las estaciones", xlabel="m s. n. m.")
fig.tight_layout(); plt.show()
print("Horas de datos por departamento (%):")
print((P.depto.value_counts(normalize=True) * 100).round(1).to_string())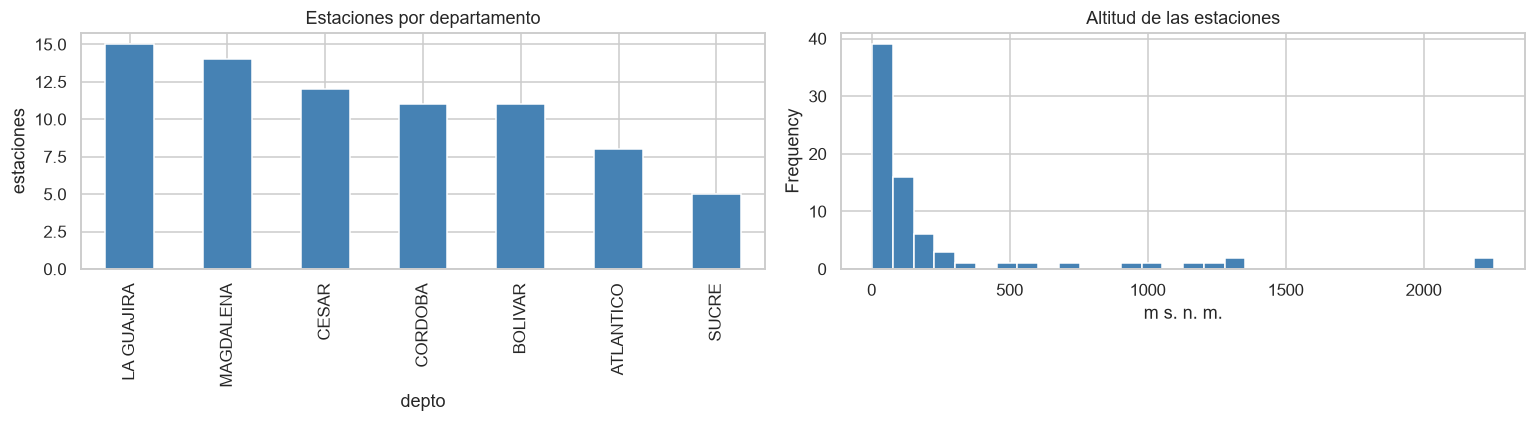
Horas de datos por departamento (%):
depto
LA GUAJIRA   18.300
MAGDALENA    17.300
BOLIVAR      16.400
CESAR        16.400
CORDOBA      11.800
ATLANTICO    10.700
SUCRE         9.000
La red cubre los siete departamentos de manera bastante pareja (entre el 9 % y el 18 % de las horas cada
uno), pero está sesgada hacia las zonas bajas: la mediana de altitud es de 75 m y solo unas pocas estaciones
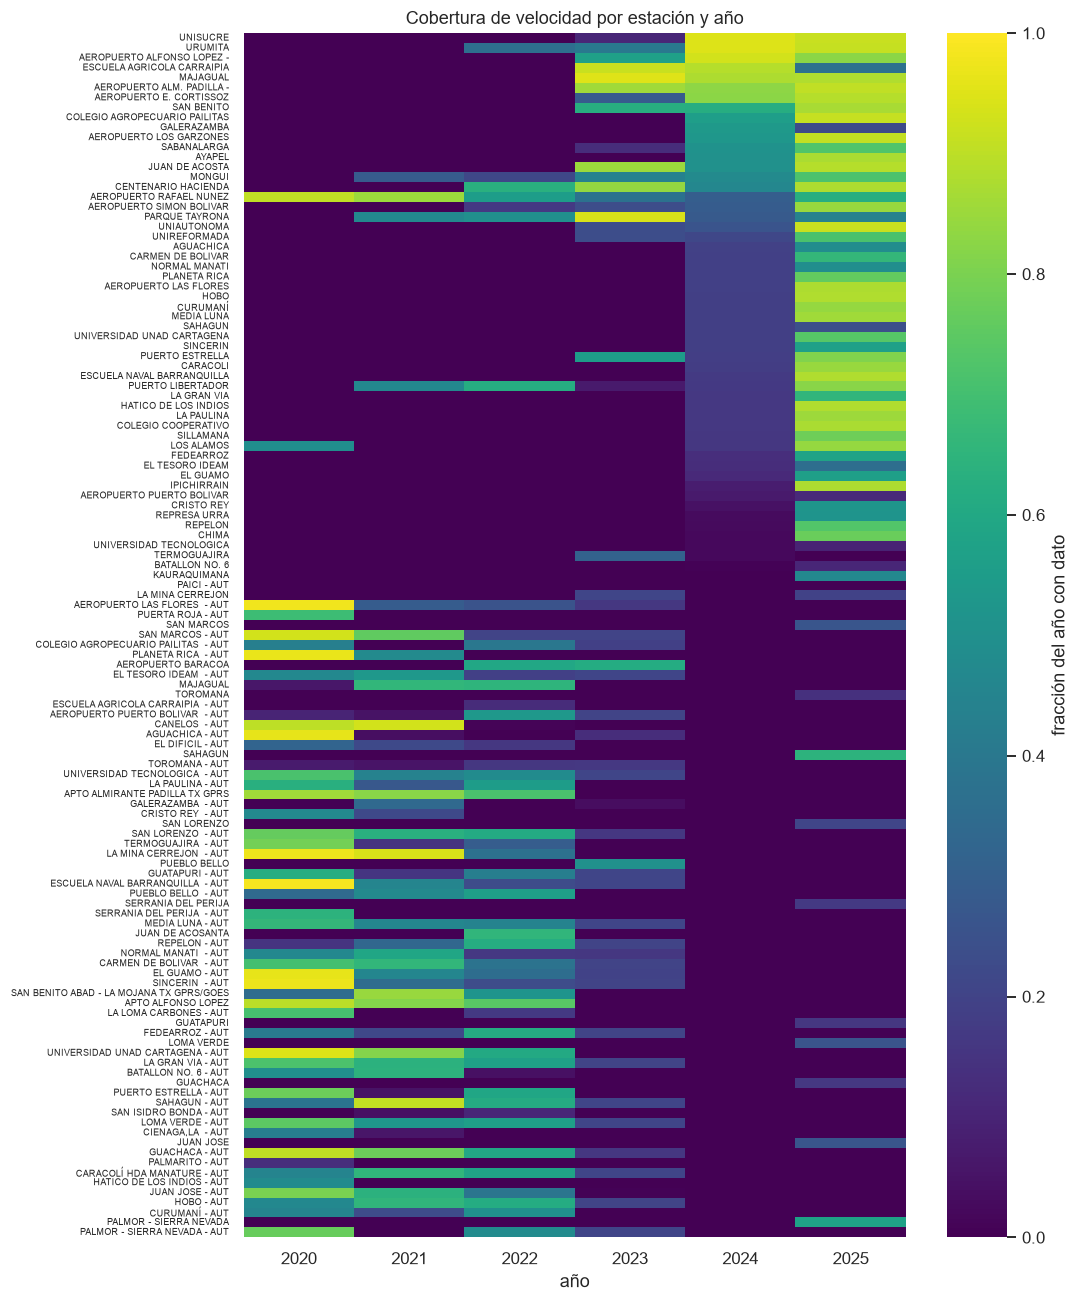
están en la Sierra Nevada o en el Perijá. La red también cambia de un año a otro (entre 47 y 66 estaciones),
y 2025 tiene casi el doble de estación-horas que 2023. Los resultados describen, por tanto, sobre todo el
viento de las tierras bajas del Caribe, y conviene medir también cómo se comporta el modelo en estaciones que
no participaron en su ajuste.
1.6.3 Consideraciones éticas
Los datos son mediciones ambientales de estaciones públicas: no contienen información personal ni permiten identificar a nadie, y las coordenadas corresponden a infraestructura que el IDEAM ya publica. El riesgo principal está en el uso. Como los datos no están validados oficialmente, no deberían servir como evidencia jurídica ni para tomar decisiones de seguridad sin una validación adicional, tal como advierte la propia fuente.
2. Análisis exploratorio de datos
2.0 Reserva del conjunto de prueba y construcción del conjunto de modelado
Antes de tomar cualquier decisión de modelado apartamos el año 2025 completo como conjunto de prueba. La sección 1 describe todo el periodo, incluido 2025, pero solo con fines descriptivos y de control de calidad; a partir de aquí el análisis exploratorio y todas las decisiones de modelado (predictoras, transformaciones e hiperparámetros) usan únicamente 2020–2024. La lista de vecinos del rezago espacial se define con las coordenadas del catálogo, que son metadatos estáticos. La partición es cronológica porque lo que queremos es pronosticar el futuro (sección 2.6).
Las predictoras se construyen estación por estación sobre una rejilla horaria completa, de modo que un hueco
queda como NaN en lugar de tomar otra fecha, y usan solo horas completas hasta t, que es lo que se conoce al
emitir el pronóstico en t + 1 h. Construirlas no requiere ajustar nada con los datos.
PT = P[P.hora < TEST_INI].copy()  # EDA solo con entrenamiento
print(f"Entrenamiento (EDA): {len(PT):,} estación-horas 2020–2024 | "
      f"prueba reservada: {(P.hora >= TEST_INI).sum():,} estación-horas 2025")

coords = est[["lat", "lon"]]
DIST = haversine_matriz(coords.lat.to_numpy(), coords.lon.to_numpy())
d_ = DIST.copy(); np.fill_diagonal(d_, np.inf)
vecinos = {e: coords.index[np.argsort(d_[i])[:K_VECINOS]].tolist() for i, e in enumerate(coords.index)}
ancho_vel = P.pivot(index="hora", columns="est", values="vel")
vel_vecinos = pd.DataFrame({e: ancho_vel[v].mean(axis=1) for e, v in vecinos.items()})

# rejilla horaria completa por estación
G = (P.set_index("hora").groupby("est")[["vel", "dir_sin", "dir_cos", "dir_constancia", "temp", "pres", "altitud"]]
     .apply(lambda g: g.asfreq("h")))


def construir(g, vv=None):
    vv = vel_vecinos if vv is None else vv
    e = g.name
    g = g.droplevel(0)
    X = pd.DataFrame(index=g.index)
    v = g.vel
    for L in [0, 1, 2, 3, 6, 12, 23]:
        X[f"vel_l{L}"] = v.shift(L)
    X["vel_m24"] = v.rolling(24, min_periods=18).mean()
    # aproximación de las componentes este (u) y norte (w) del viento, convención "desde": velocidad media
    # × vector medio de dirección. Como ese vector tiene norma = constancia, equivale a ponderar por ella
    X["u"], X["w"] = -v * g.dir_sin, -v * g.dir_cos
    X["u_m24"] = X.u.rolling(24, min_periods=18).mean()
    X["w_m24"] = X.w.rolling(24, min_periods=18).mean()
    X["dir_constancia"] = g.dir_constancia
    X["temp"] = g.temp
    X["temp_d24"] = g.temp - g.temp.shift(24)
    X["temp_amp24"] = g.temp.rolling(24, min_periods=18).max() - g.temp.rolling(24, min_periods=18).min()
    X["pres"] = g.pres
    X["pres_d3"], X["pres_d24"] = g.pres - g.pres.shift(3), g.pres - g.pres.shift(24)
    X["vel_vecinos"] = vv[e].reindex(g.index)
    X["vel_vecinos_m24"] = X.vel_vecinos.rolling(24, min_periods=18).mean()
    t_y = g.index + pd.Timedelta(H, "h")
    X["hy_sin"], X["hy_cos"] = np.sin(2 * np.pi * t_y.hour / 24), np.cos(2 * np.pi * t_y.hour / 24)
    X["doy_sin"] = np.sin(2 * np.pi * t_y.dayofyear / 365.25)
    X["doy_cos"] = np.cos(2 * np.pi * t_y.dayofyear / 365.25)
    X["altitud"] = g.altitud.ffill().bfill()
    X["hora_y"], X["mes_y"] = t_y.hour, t_y.month
    X["y"] = v.shift(-H)
    X["t_y"] = t_y
    return X


D = G.groupby(level="est", group_keys=True).apply(construir).reset_index().rename(columns={"hora": "t"})
F_UNI = ["vel_l0", "vel_l1", "vel_l2", "vel_l3", "vel_l6", "vel_l12", "vel_l23", "vel_m24", "hy_sin", "hy_cos"]
F_MET = F_UNI + ["u", "w", "u_m24", "w_m24", "dir_constancia", "temp", "temp_d24", "temp_amp24",
                 "pres", "pres_d3", "pres_d24", "doy_sin", "doy_cos", "altitud"]
F_ESP = F_MET + ["vel_vecinos", "vel_vecinos_m24"]
D_todo = D                                   # antes de exigir casos completos (sección 3.2)
D = D.dropna(subset=F_ESP + ["y"]).reset_index(drop=True)
TR = D[D.t_y < TEST_INI]                      # el objetivo de entrenamiento siempre es anterior a 2025
TE = D[(D.t >= TEST_INI)]                      # prueba: pronósticos emitidos en 2025
frontera = len(D) - len(TR) - len(TE)
print(f"Conjunto de modelado (casos completos): {len(D):,} filas | {D.est.nunique()} estaciones")
print(f"  {frontera} filas de las últimas 24 h de 2024 quedan fuera de ambos conjuntos: su predictora es de 2024 "
      "pero su objetivo cae en 2025 (actúan como separación entre entrenamiento y prueba)")
print(f"  entrenamiento: {len(TR):,} filas ({TR.t.min():%Y-%m-%d} a {TR.t_y.max():%Y-%m-%d})")
print(f"  prueba:        {len(TE):,} filas ({TE.t.min():%Y-%m-%d} a {TE.t_y.max():%Y-%m-%d})")
Entrenamiento (EDA): 946,851 estación-horas 2020–2024 | prueba reservada: 355,756 estación-horas 2025
Conjunto de modelado (casos completos): 611,727 filas | 62 estaciones
  705 filas de las últimas 24 h de 2024 quedan fuera de ambos conjuntos: su predictora es de 2024 pero su objetivo cae en 2025 (actúan como separación entre entrenamiento y prueba)
  entrenamiento: 400,163 filas (2020-01-02 a 2024-12-31)
  prueba:        210,859 filas (2025-01-01 a 2025-12-31)
2.1 Análisis de la variable objetivo
y = PT.vel.dropna()
desc = y.describe(percentiles=[.01, .05, .25, .5, .75, .95, .99])
print(desc.round(3).to_string())
print(f"Asimetría: {stats.skew(y):.3f} | curtosis (exceso): {stats.kurtosis(y):.3f} | "
      f"horas con 0 m/s: {100 * (y == 0).mean():.2f} %")
_, lam = stats.yeojohnson(muestra(y, 50000))
print(f"λ de Yeo-Johnson: {lam:.3f} (1 = sin transformación, 0 ≈ logaritmo)")

fig, axs = plt.subplots(1, 3, figsize=(16, 4))
sns.histplot(y, bins=100, ax=axs[0], color="steelblue")
axs[0].set(title="Velocidad horaria del viento (train)", xlabel="m/s")
sns.histplot(np.log1p(y), bins=100, ax=axs[1], color="darkorange")
axs[1].set(title="log(1 + velocidad)", xlabel="log(1 + m/s)")
stats.probplot(muestra(y, 20000), dist="norm", plot=axs[2])
axs[2].set_title("QQ-plot (muestra de 20 000)")
fig.tight_layout(); plt.show()
count 946851.000
mean 1.954
std 1.508
min 0.000
1% 0.163
5% 0.400
25% 0.867
50% 1.500
75% 2.613
95% 5.083
99% 6.933
max 21.067
Asimetría: 1.568 | curtosis (exceso): 3.327 | horas con 0 m/s: 0.42 %
λ de Yeo-Johnson: -0.425 (1 = sin transformación, 0 ≈ logaritmo)
fig, axs = plt.subplots(1, 3, figsize=(17, 4))
ciclo = PT.groupby(PT.hora.dt.hour).vel.quantile([.25, .5, .75]).unstack()
axs[0].fill_between(ciclo.index, ciclo[.25], ciclo[.75], alpha=.3, label="rango intercuartil")
axs[0].plot(ciclo.index, ciclo[.5], "o-", label="mediana")
axs[0].set(title="Ciclo diario", xlabel="hora local", ylabel="m/s"); axs[0].legend()
mes = PT.groupby(PT.hora.dt.month).vel.quantile([.25, .5, .75]).unstack()
axs[1].fill_between(mes.index, mes[.25], mes[.75], alpha=.3)
axs[1].plot(mes.index, mes[.5], "o-")
axs[1].set(title="Ciclo anual", xlabel="mes", ylabel="m/s", xticks=range(1, 13))
mapa_base(axs[2])
sc = axs[2].scatter(est.lon, est.lat, c=PT.groupby("est").vel.mean().reindex(est.index), s=40, cmap="viridis",
                    edgecolor="k", lw=.3)
plt.colorbar(sc, ax=axs[2], label="velocidad media (m/s)")
axs[2].set(title="Velocidad media por estación", xlabel="longitud", ylabel="latitud")
fig.tight_layout(); plt.show()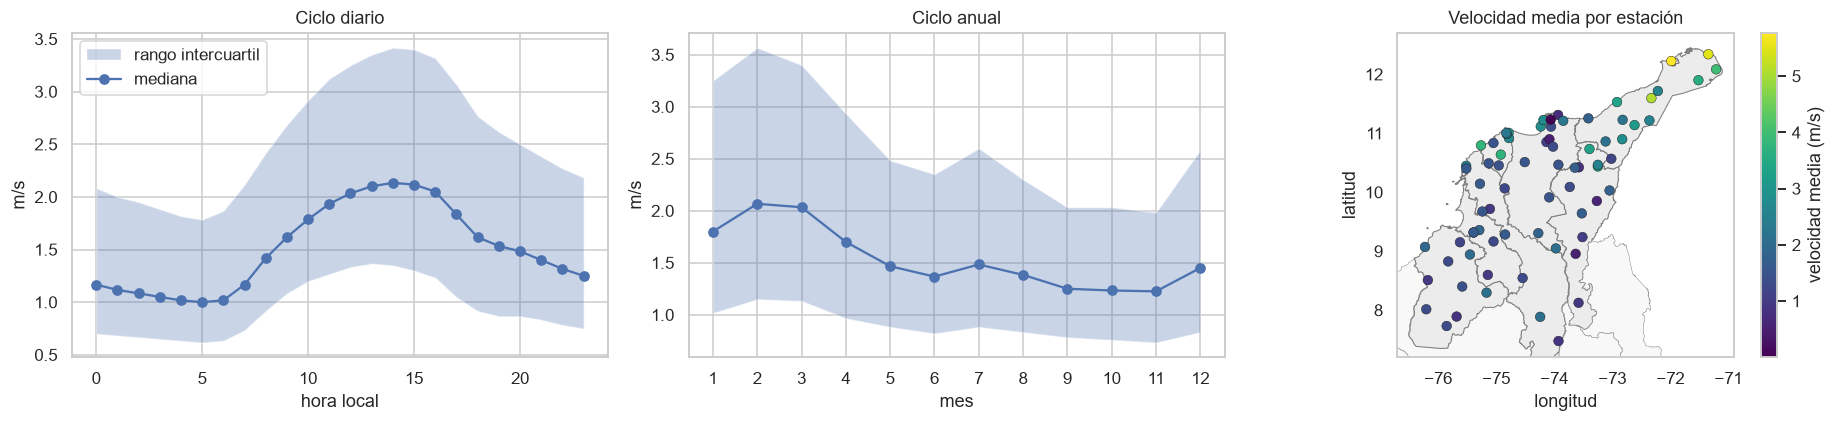
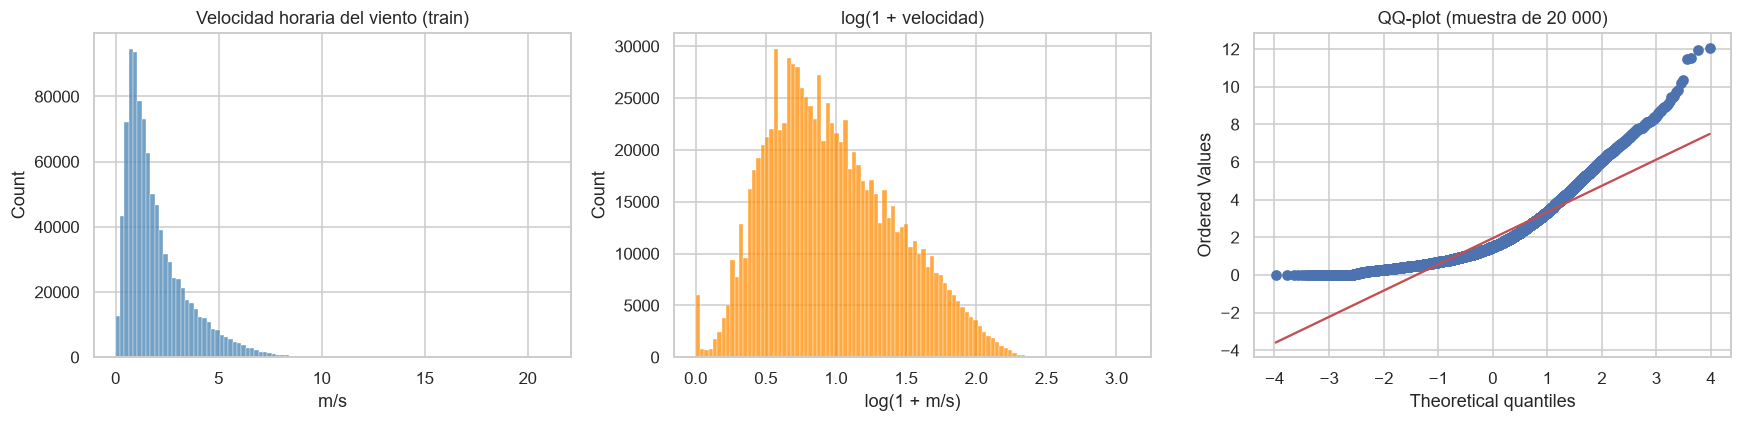
La velocidad tiene asimetría positiva (1.57) y colas moderadas (curtosis de exceso de 3.3): la mediana es de
1.5 m/s, pero el 1 % de las horas supera los 6.9 m/s. Las calmas exactas son raras (0.4 % de las horas en
0 m/s). El λ = −0.43 de Yeo-Johnson sugiere que un logaritmo haría más simétrica la distribución; si eso
mejora o no el pronóstico lo decide la validación cruzada (sección 3.1).
En los gráficos se ven tres fuentes claras de variación: un ciclo diario fuerte, con el mínimo hacia las 5 h
y el máximo hacia las 14 h (la brisa diurna); un ciclo anual, con más viento de diciembre a marzo, en la
temporada seca de los alisios; y diferencias fijas entre estaciones, porque La Guajira, al noreste, supera
los 4–5 m/s de media, mientras que el interior de Córdoba y Bolívar ronda 1 m/s. De aquí salen dos
consecuencias para el modelado: las métricas deben calcularse también por estación, porque el R² global se
infla con esas diferencias fijas, y los ciclos diario y anual deben entrar como predictoras.
2.2 Análisis unidimensional
num = PT[["vel", "temp", "pres", "dir_constancia"]]


def resumen_num(s):
    s = s.dropna()
    q1, q3 = s.quantile([.25, .75])
    iqr = q3 - q1
    return pd.Series({"n": len(s), "media": s.mean(), "mediana": s.median(), "desv. est.": s.std(),
                      "p1": s.quantile(.01), "p99": s.quantile(.99), "asimetría": stats.skew(s),
                      "curtosis": stats.kurtosis(s),
                      "% atípicos IQR": 100 * ((s < q1 - 1.5 * iqr) | (s > q3 + 1.5 * iqr)).mean(),
                      "p normalidad (D'Agostino, n=5000)": stats.normaltest(muestra(s, 5000)).pvalue})


tabla_uni = num.apply(resumen_num).T
tabla_uni.loc["altitud (por estación)"] = resumen_num(est.altitud)
tabla_unifig, axs = plt.subplots(2, 3, figsize=(16, 8))
for ax, v, u in zip(axs.flat, ["vel", "temp", "pres", "dir_constancia"], ["m/s", "°C", "hPa", "0–1"]):
sns.histplot(muestra(PT[v].dropna(), 200000), bins=80, ax=ax, color="steelblue")
ax.set(title=v, xlabel=u)
sns.boxplot(data=muestra(PT, 200000), x="depto", y="vel", ax=axs[1, 2], showfliers=False,
color="lightsteelblue")
axs[1, 2].set(title="Velocidad por departamento", xlabel="", ylabel="m/s")
axs[1, 2].tick_params(axis="x", rotation=45)
# rosa de vientos
axs[1, 1].remove()
ax = fig.add_subplot(2, 3, 5, projection="polar")
d = PT[["dir", "vel"]].dropna()
sect = (np.floor(((d.dir + 11.25) % 360) / 22.5)).astype(int)
cuenta = sect.value_counts(normalize=True).sort_index()
vmed = d.vel.groupby(sect).mean().sort_index()
barras = ax.bar(np.deg2rad(cuenta.index * 22.5), cuenta.values, width=np.deg2rad(22.5), bottom=0,
color=plt.cm.viridis(vmed.values / vmed.max()), edgecolor="k", lw=.3)
ax.set_theta_zero_location("N"); ax.set_theta_direction(-1)
ax.set_title("Rosa de vientos (color = velocidad media)", pad=15)
fig.tight_layout(); plt.show()
ang = np.arctan2(PT.dir_sin.mean(), PT.dir_cos.mean())
print(f"Dirección media vectorial: {np.rad2deg(ang) % 360:.0f}° | longitud del vector medio: "
f"{np.hypot(PT.dir_sin.mean(), PT.dir_cos.mean()):.2f}")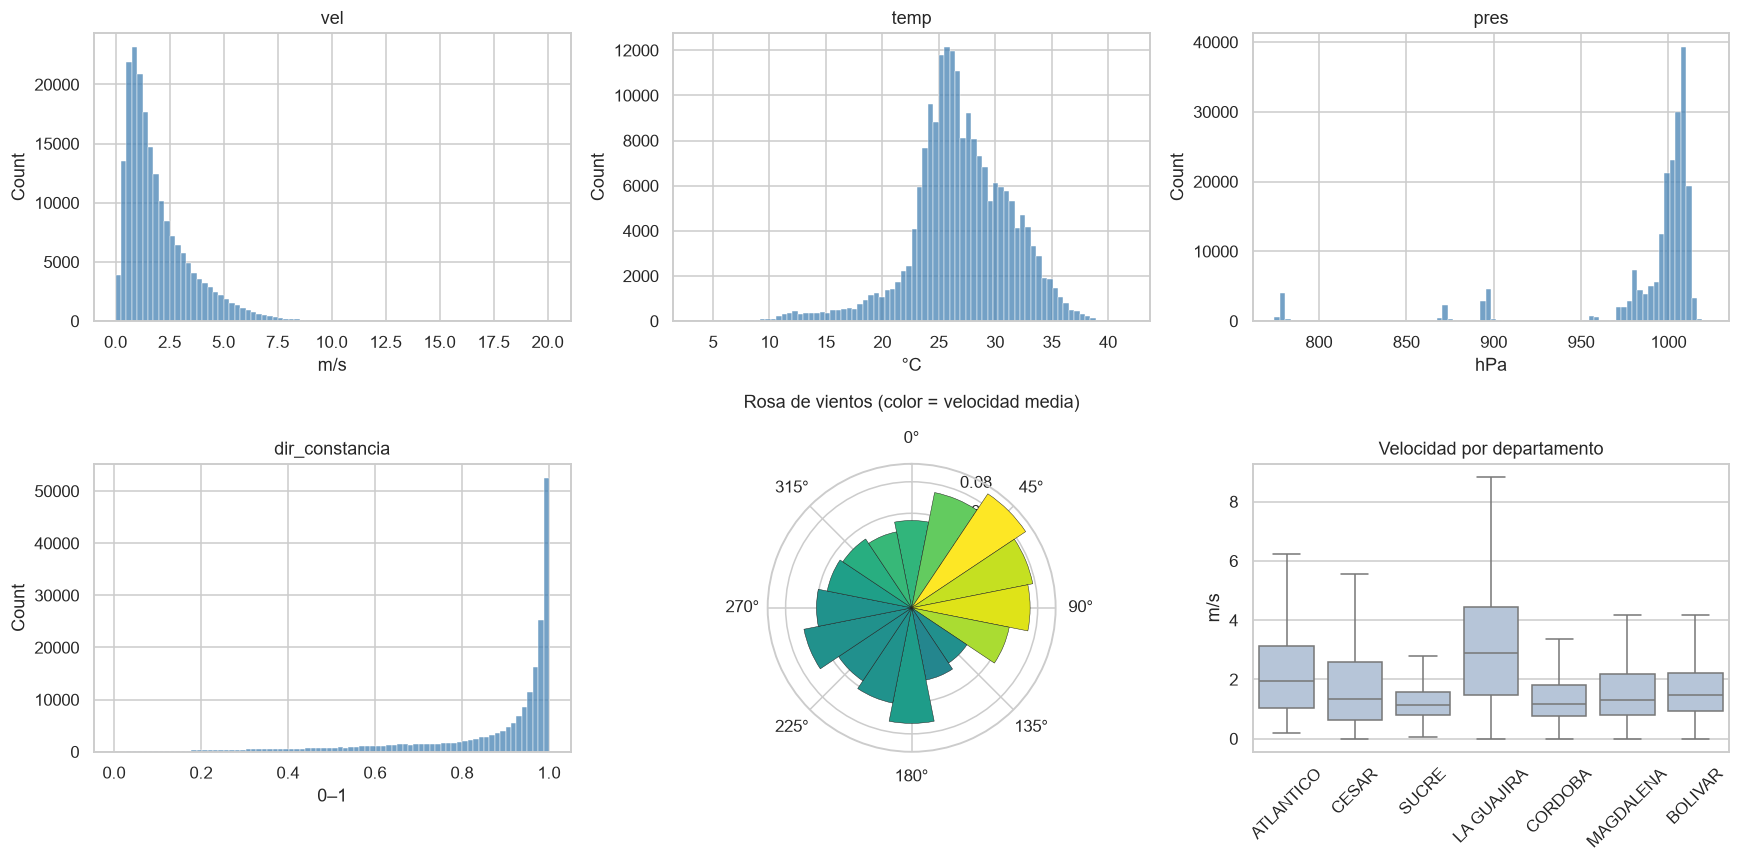
Dirección media vectorial: 57° | longitud del vector medio: 0.06
cat = pd.DataFrame({"estaciones": est.categoria.value_counts(),
                    "% de horas": (PT.categoria.value_counts(normalize=True) * 100).round(1)})
catNinguna variable sigue una distribución normal. Con tantos datos las pruebas de normalidad siempre rechazan,
pero la asimetría y la curtosis apuntan en la misma dirección. La presión es bimodal y muy asimétrica (−3.5)
porque mezcla estaciones costeras (≈ 1010 hPa) con estaciones de montaña (≈ 780 hPa); sus “atípicos” por IQR
(10 %) no son errores sino altitud, y por eso la usamos junto con la altitud y como tendencia (su cambio en 3 y
en 24 h). La constancia de la dirección se concentra cerca de 1 (dirección estable dentro de la hora), con
una cola de horas de viento variable.
La dirección es circular, así que su media aritmética no tiene sentido. La rosa de vientos muestra que
predominan los vientos del noreste y del este, los alisios, que además son los más fuertes. Como la red
mezcla regímenes opuestos, el vector medio global es casi nulo (0.06), y la dirección tiene que tratarse por
estación y en forma de componentes u/w. Entre las variables categóricas, “Sinóptica Secundaria” tiene una
sola estación y “Pluviométrica” y “Agrometeorológica” cuatro cada una; son categorías tan raras que no usamos
la categoría de la estación como predictora.
m = PT[["vel", "temp", "pres", "dir_sin", "dir_cos", "dir_constancia", "altitud", "lat", "lon"]].dropna()
m = muestra(m, 200000)
fig, axs = plt.subplots(1, 2, figsize=(15, 6))
sns.heatmap(m.corr("pearson"), annot=True, fmt=".2f", cmap="RdBu_r", center=0, ax=axs[0], cbar=False)
axs[0].set_title("Pearson")
sns.heatmap(m.corr("spearman"), annot=True, fmt=".2f", cmap="RdBu_r", center=0, ax=axs[1], cbar=False)
axs[1].set_title("Spearman")
fig.tight_layout(); plt.show()

fig, axs = plt.subplots(1, 3, figsize=(17, 4.5))
for ax, v in zip(axs[:2], ["temp", "pres"]):
    hb = ax.hexbin(m[v], m.vel, gridsize=60, bins="log", cmap="viridis", mincnt=1)
    ax.set(xlabel=v, ylabel="vel (m/s)", title=f"vel vs. {v}")
axs[2].scatter(est.altitud, PT.groupby("est").vel.mean().reindex(est.index), c="steelblue", edgecolor="k", lw=.3)
axs[2].set(xlabel="altitud (m)", ylabel="velocidad media (m/s)", title="Velocidad media vs. altitud (por estación)")
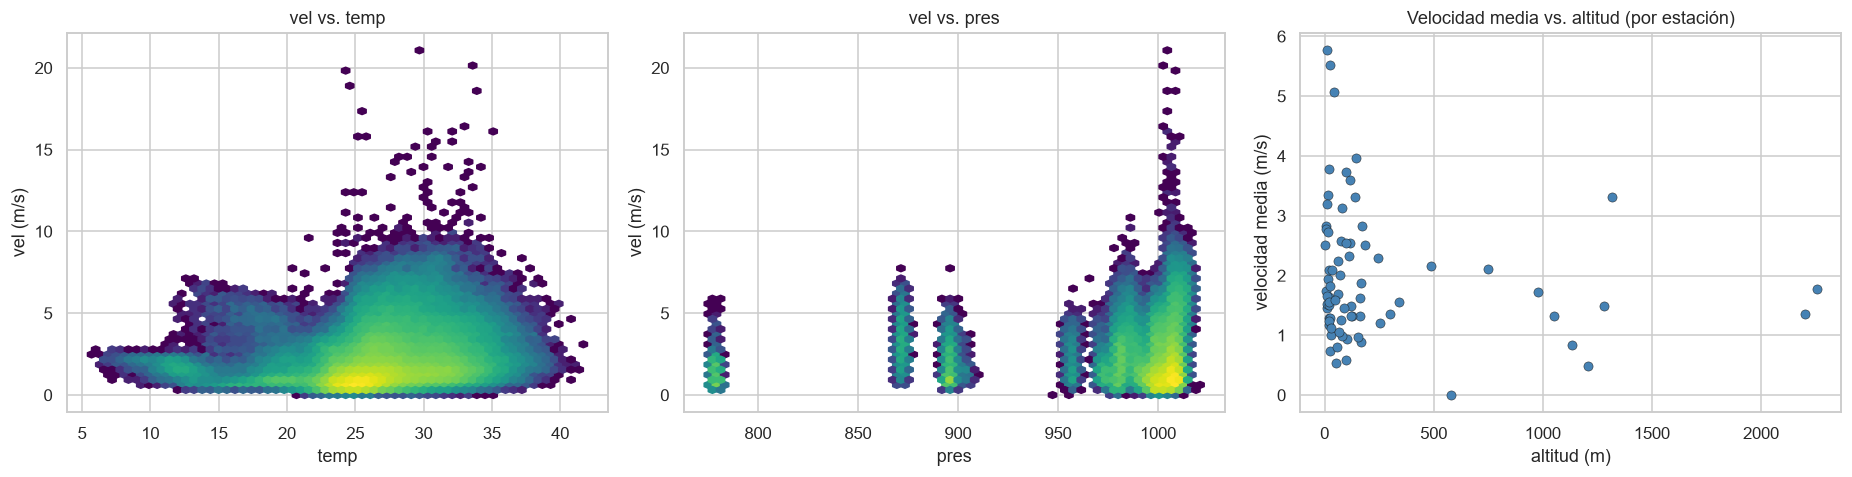
fig.tight_layout(); plt.show()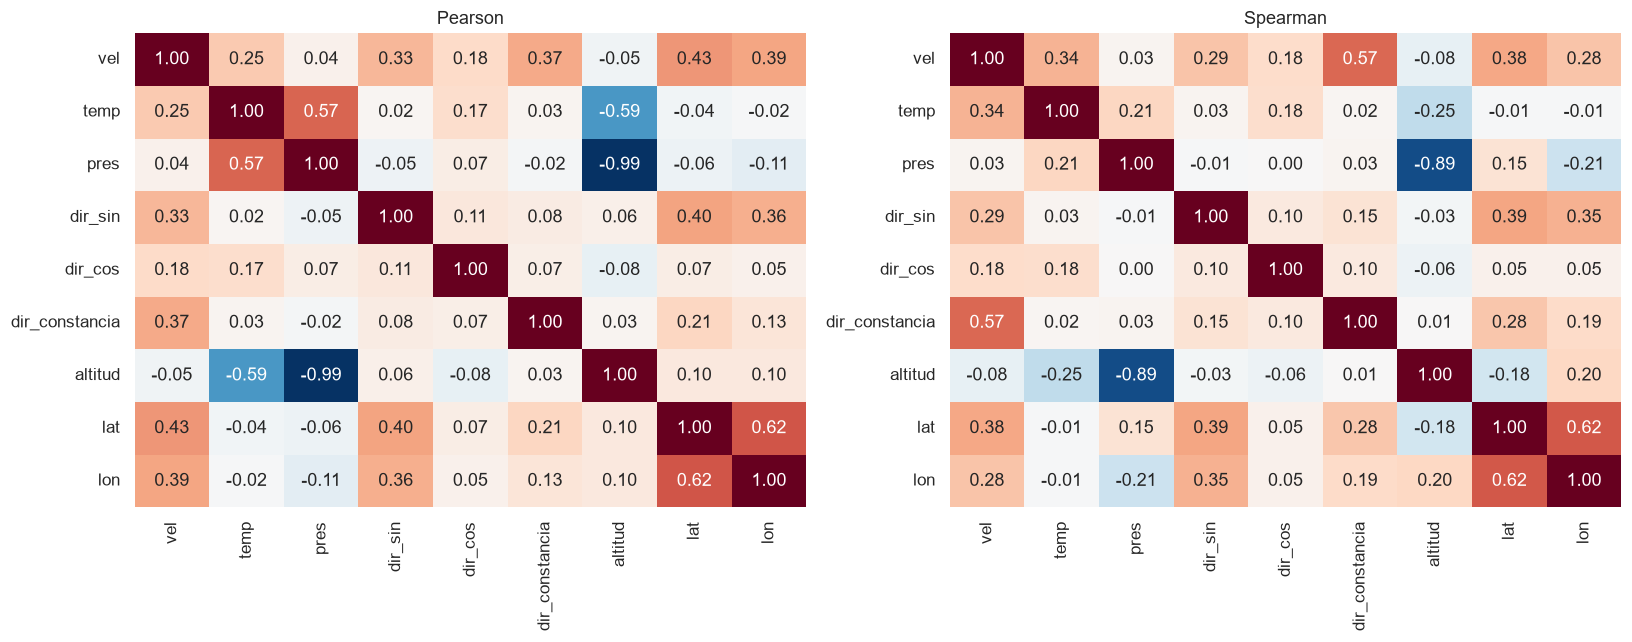
2.3.2 Categóricas vs. numéricas y categóricas vs. categóricas
Con tantos datos casi cualquier diferencia resulta significativa, así que reportamos también tamaños de
efecto (ε² de Kruskal-Wallis y V de Cramér) y corregimos por comparaciones múltiples con el método de Holm.
Las pruebas se hacen por estación (n ≈ 70), para no inflar la significancia con horas autocorrelacionadas.
est["vel_media"] = PT.groupby("est").vel.mean().reindex(est.index)
est["temp_media"] = PT.groupby("est").temp.mean().reindex(est.index)
pruebas = []
for cat_v in ["depto", "categoria"]:
    for num_v in ["vel_media", "temp_media", "altitud"]:
        e = est.dropna(subset=[num_v])
        grupos = [g[num_v].to_numpy() for _, g in e.groupby(cat_v) if len(g) >= 2]
        H_, p = stats.kruskal(*grupos)
        pruebas.append({"categórica": cat_v, "numérica": num_v, "H": H_, "p": p,
                        "ε²": H_ / (len(e) - 1), "grupos": len(grupos)})
kw = pd.DataFrame(pruebas)
kw["p (Holm)"] = multipletests(kw.p, method="holm")[1]
kwtabla = pd.crosstab(est.depto, est.categoria)
chi2, p, gl, _ = stats.chi2_contingency(tabla)
v_cramer = np.sqrt(chi2 / (tabla.values.sum() * (min(tabla.shape) - 1)))
print(f"Departamento × categoría (por estación): χ² = {chi2:.1f}, gl = {gl}, p = {p:.3g}, V de Cramér = {v_cramer:.2f}")
tablaDepartamento × categoría (por estación): χ² = 24.0, gl = 30, p = 0.774, V de Cramér = 0.25
2.3.3 Predictoras vs. variable objetivo y multicolinealidad
mu = muestra(TR, 20000)
mi = mutual_info_regression(mu[F_ESP], mu.y, random_state=SEED)
asoc = pd.DataFrame({"Spearman con y": mu[F_ESP].corrwith(mu.y, method="spearman"),
                     "información mutua": mi}, index=F_ESP).sort_values("información mutua", ascending=False)
Xv = StandardScaler().fit_transform(mu[F_ESP])
Xv = np.column_stack([np.ones(len(Xv)), Xv])
asoc["VIF"] = pd.Series([variance_inflation_factor(Xv, i + 1) for i in range(len(F_ESP))], index=F_ESP)
asocfig, ax = plt.subplots(figsize=(12, 10))
sns.heatmap(mu[F_ESP + ["y"]].corr(), cmap="RdBu_r", center=0, ax=ax, square=True, cbar_kws={"shrink": .6})
ax.set_title("Correlación de Pearson entre predictoras y objetivo (train)")
fig.tight_layout(); plt.show()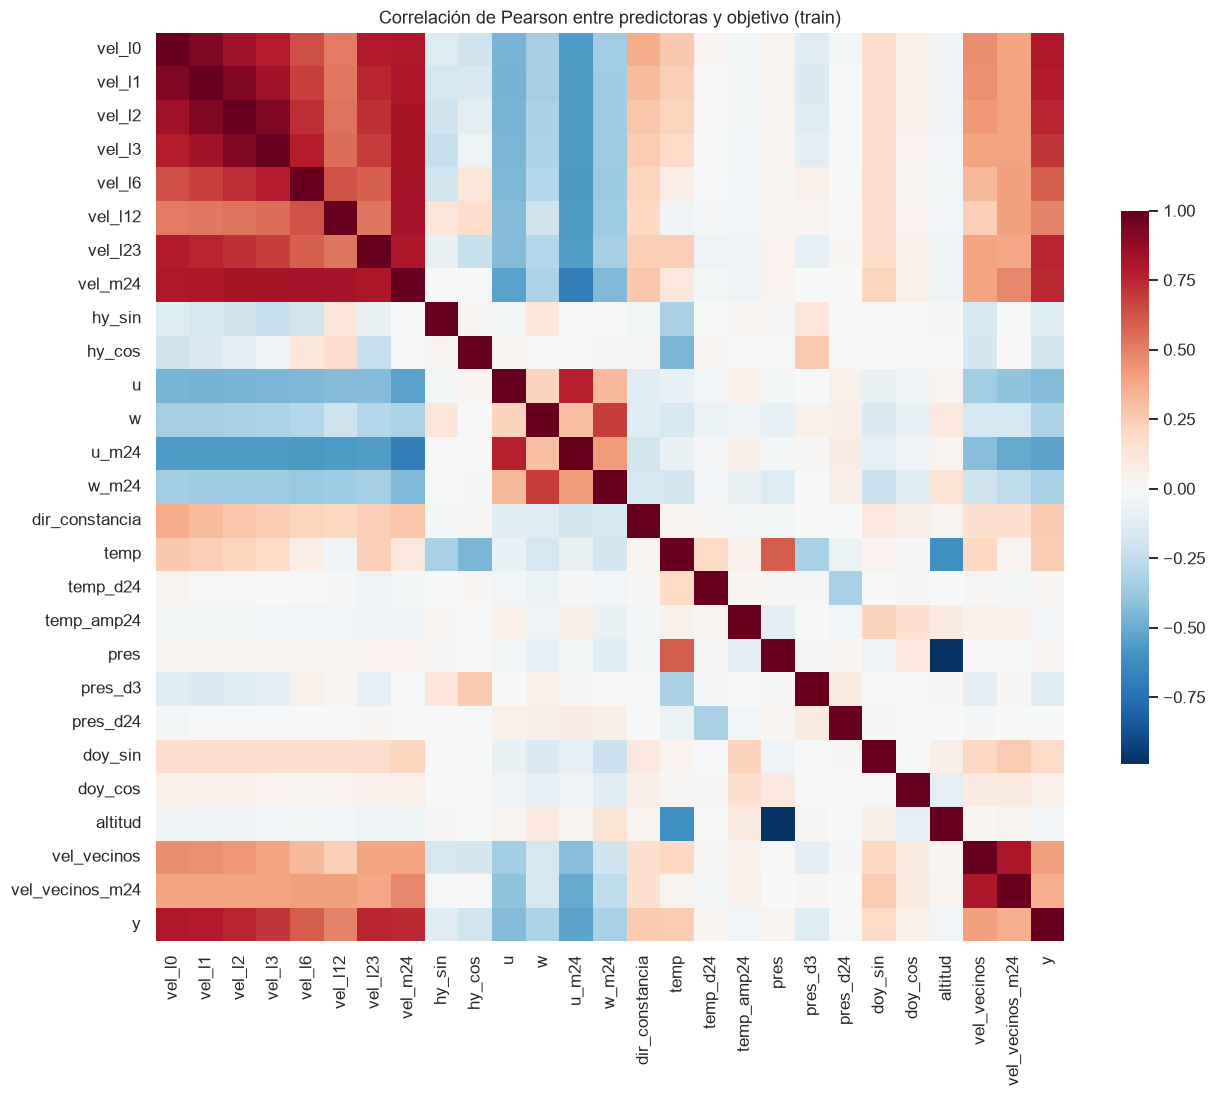
La velocidad se asocia con la temperatura, porque las horas más cálidas son también las más ventosas por el ciclo diario, y con la dirección. Con la presión la correlación agregada es casi nula, ya que la presión refleja sobre todo la altitud de cada estación.
Entre grupos, y después de la corrección de Holm, solo el departamento se asocia de forma significativa con
la velocidad media de la estación, con un efecto grande (ε² = 0.31) que refleja el gradiente que va de La
Guajira, al noreste, hacia el suroeste. El departamento y la categoría de la estación son independientes
(p = 0.77).
Frente al objetivo, las predictoras más informativas son la velocidad actual y sus rezagos de 1 a 3 h y de
23 h (Spearman entre 0.65 y 0.76; información mutua entre 0.34 y 0.50). Las componentes u/w y la altitud
tienen una información mutua alta pero una correlación baja, lo que indica una relación no lineal que un
modelo lineal no aprovecha del todo. La temperatura, la presión y el calendario aportan poco por separado.
Los rezagos de velocidad (VIF entre 5 y 24) y el par altitud–presión (VIF ≈ 56) son muy redundantes. Eso no
impide predecir, pero obliga a interpretar los coeficientes con cautela y justifica usar un modelo
regularizado.
2.4 Análisis multivariado
Xs = StandardScaler().fit_transform(muestra(TR[F_ESP], 100000))
pca = PCA(random_state=SEED).fit(Xs)
var_acum = np.cumsum(pca.explained_variance_ratio_)
fig, axs = plt.subplots(1, 2, figsize=(15, 4.5))
axs[0].bar(range(1, len(var_acum) + 1), pca.explained_variance_ratio_, color="steelblue", label="individual")
axs[0].plot(range(1, len(var_acum) + 1), var_acum, "o-", color="darkorange", label="acumulada")
axs[0].axhline(.9, ls="--", c="gray"); axs[0].legend()
axs[0].set(title="PCA de las predictoras (estandarizadas)", xlabel="componente", ylabel="varianza explicada")
cargas = pd.DataFrame(pca.components_[:3].T, index=F_ESP, columns=["PC1", "PC2", "PC3"])
sns.heatmap(cargas, cmap="RdBu_r", center=0, ax=axs[1], annot=True, fmt=".2f", annot_kws={"size": 7})
axs[1].set_title("Cargas de las 3 primeras componentes")
fig.tight_layout(); plt.show()
print(f"Componentes para explicar el 90 % de la varianza: {np.argmax(var_acum >= .9) + 1} de {len(F_ESP)}")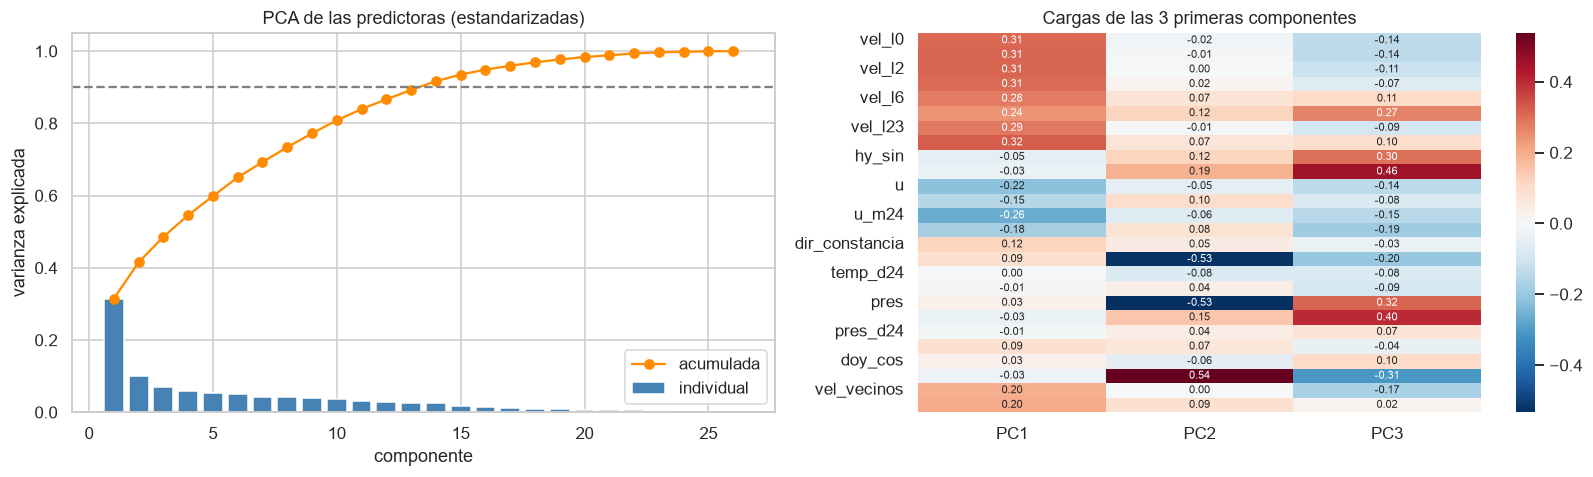
Componentes para explicar el 90 % de la varianza: 14 de 26
# atípicos multivariados relativos a cada estación: variables estandarizadas dentro de su estación
cols4 = ["vel", "temp", "pres", "dir_constancia"]
z = PT.dropna(subset=cols4).groupby("est")[cols4].transform(lambda s: (s - s.mean()) / s.std()).dropna()
zs = muestra(z, 100000)
inv = np.linalg.inv(np.cov(zs.T))
d2 = np.einsum("ij,jk,ik->i", zs.values, inv, zs.values)
umbral = stats.chi2.ppf(.999, df=len(cols4))
iso = IsolationForest(random_state=SEED, contamination="auto").fit(zs)
atip_iso = iso.predict(zs) == -1
print(f"Mahalanobis (χ² 99.9 %): {100 * (d2 > umbral).mean():.2f} % de atípicos multivariados")
print(f"Isolation Forest: {100 * atip_iso.mean():.2f} % | coincidencia con Mahalanobis entre los atípicos: "
      f"{100 * (atip_iso & (d2 > umbral)).sum() / max(1, (d2 > umbral).sum()):.0f} %")
print("Perfil medio (z) de los atípicos de Mahalanobis:")
print(zs[d2 > umbral].mean().round(2).to_string())
Mahalanobis (χ² 99.9 %): 1.21 % de atípicos multivariados
Isolation Forest: 15.08 % | coincidencia con Mahalanobis entre los atípicos: 100 %
Perfil medio (z) de los atípicos de Mahalanobis:
vel 0.540
temp 0.150
pres -0.190
dir_constancia -3.340
perfil = pd.DataFrame({
    "vel_media": PT.groupby("est").vel.mean(),
    "vel_desv": PT.groupby("est").vel.std(),
    "amplitud_diaria": PT.groupby(["est", PT.hora.dt.hour]).vel.mean().groupby("est").agg(lambda s: s.max() - s.min()),
    "constancia_dir": PT.groupby("est").dir_constancia.mean(),
    "temp_media": PT.groupby("est").temp.mean(),
}).join(est[["altitud", "lat", "lon"]]).dropna()
Zp = StandardScaler().fit_transform(perfil.drop(columns=["lat", "lon"]))
sil = {k: silhouette_score(Zp, KMeans(k, n_init=20, random_state=SEED).fit_predict(Zp)) for k in range(2, 7)}
k_opt = max(sil, key=sil.get)
perfil["grupo"] = KMeans(k_opt, n_init=20, random_state=SEED).fit_predict(Zp)
print("Silueta por k:", {k: round(s, 3) for k, s in sil.items()}, "→ k =", k_opt)
fig, ax = plt.subplots(figsize=(8, 7))
mapa_base(ax)
sns.scatterplot(data=perfil, x="lon", y="lat", hue="grupo", size="vel_media", palette="Set1", ax=ax, sizes=(30, 250))
ax.set_title(f"Grupos de estaciones por régimen de viento (k-means, k = {k_opt})")
plt.show()
perfil.groupby("grupo").mean().round(2).assign(estaciones=perfil.grupo.value_counts().sort_index())
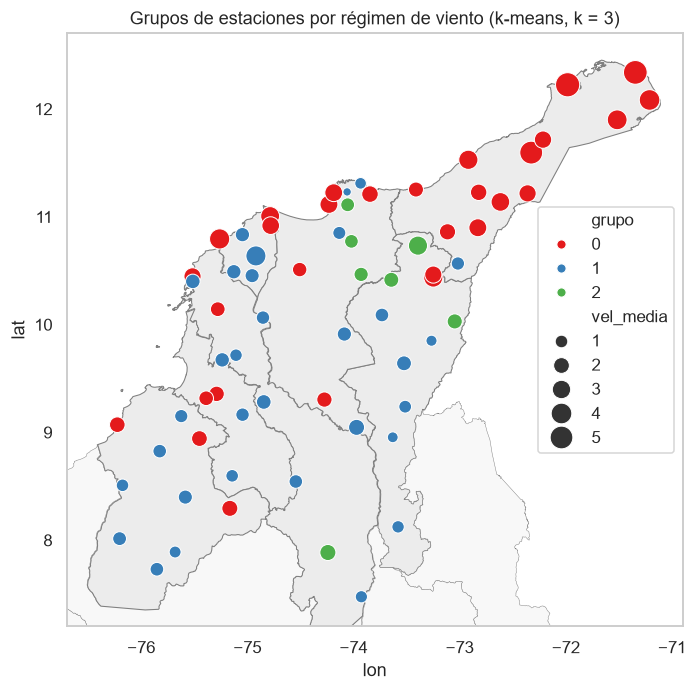
Silueta por k: {2: 0.31, 3: 0.362, 4: 0.319, 5: 0.325, 6: 0.34} → k = 3
Hacen falta 14 de las 26 componentes principales para explicar el 90 % de la varianza. La primera recoge el
“nivel de viento” (todos los rezagos de velocidad) y las siguientes separan, por un lado, la dirección y la
época del año y, por otro, la altitud y la presión. Hay mucha redundancia dentro de cada grupo de variables,
pero los grupos aportan información distinta entre sí.
Comparando cada hora con la climatología de su propia estación, el 1.2 % de las horas son atípicas según la
distancia de Mahalanobis (umbral χ² al 99.9 %), y todas lo son también para Isolation Forest. Lo que tienen
en común es una dirección muy variable dentro de la hora (la constancia está 3.3 desviaciones por debajo de lo
normal) y algo más de viento: son horas de ráfagas o de cambio de régimen. Como se trata de fenómenos reales,
no las eliminamos.
El k-means sobre el perfil de cada estación separa tres regímenes: 30 estaciones ventosas del norte y de la
costa (2.8 m/s de media y un ciclo diario amplio), 33 estaciones de tierras bajas del interior con poco viento
(1.3 m/s) y 7 estaciones de montaña (1 400 m de altitud y 20 °C). Estas diferencias estructurales son las que
inflan el R² global.
2.5 Auditoría de fuga de datos
El pronóstico se emite en t + 1 h, cuando termina la hora t, para la hora que empieza en t + 24 h (sección
1.1). Todas las predictoras usan horas completas hasta t, también las de las estaciones vecinas:
| Predictoras | Ventana | ¿Se conoce al emitir el pronóstico? |
|---|---|---|
vel_l0 … vel_l23, vel_m24 | velocidad de t − 23 a t | Sí |
u, w, u_m24, w_m24, dir_constancia | dirección y velocidad hasta t (u, w: velocidad media × vector medio de dirección, una aproximación de las componentes medias del viento) | Sí |
temp, temp_d24, temp_amp24 | temperatura de t − 24 a t | Sí |
pres, pres_d3, pres_d24 | presión de t − 24 a t | Sí |
vel_vecinos, vel_vecinos_m24 | velocidad de las 4 estaciones más cercanas hasta t | Sí |
hy_sin, hy_cos, doy_sin, doy_cos | hora y día del año del objetivo | Sí: el calendario es conocido de antemano |
altitud | catálogo | Sí (estática) |
Ninguna predictora se deriva del objetivo ni funciona como identificador de la estación. Como control adicional medimos el desempeño de cada predictora por separado, ajustada en 2020–2023 y evaluada en 2024, sin tocar la prueba; un valor cercano a 1 sería una señal de alarma.
tr_a, va_a = TR[TR.t_y < "2024-01-01"], TR[(TR.t >= "2024-01-01")]
uni = {f: r2_score(va_a.y, LinearRegression().fit(tr_a[[f]], tr_a.y).predict(va_a[[f]])) for f in F_ESP}
tabla_fuga = pd.Series(uni, name="R² univariado (2020–23 → 2024)").sort_values(ascending=False).to_frame()

# demostración: una predictora con fuga, la velocidad de la hora t + 23 (la hora justo anterior al
# objetivo, que aún no se conoce al emitir el pronóstico). Se busca por fecha exacta en la rejilla horaria
clave = pd.MultiIndex.from_arrays([D.est, D.t + pd.Timedelta(H - 1, "h")])
D_f = D.assign(fuga=G.vel.reindex(clave).to_numpy()).dropna(subset=["fuga"])
trf, vaf = D_f[D_f.t_y < "2024-01-01"], D_f[(D_f.t >= "2024-01-01") & (D_f.t_y < TEST_INI)]
r2_fuga = r2_score(vaf.y, LinearRegression().fit(trf[["fuga"]], trf.y).predict(vaf[["fuga"]]))
print(f"Con una variable filtrada del futuro (velocidad de la hora t+23, anterior al objetivo): R² = {r2_fuga:.3f}")

chequeos = pd.Series({
    "Objetivos de train con fecha ≥ 2025-01-01": int((TR.t_y >= TEST_INI).sum()),
    "Filas duplicadas (estación, t)": int(D.duplicated(["est", "t"]).sum()),
    "Estaciones de prueba también presentes en train (%)": round(100 * TE.est.isin(TR.est).mean(), 1),
    "Escalado ajustado dentro del Pipeline": "sí",
}, name="resultado").to_frame()
display(tabla_fuga.head(10)); chequeos
Con una variable filtrada del futuro (velocidad de la hora t+23, anterior al objetivo): R² = 0.847
Ninguna predictora tiene un desempeño sospechoso por sí sola. La mejor, la velocidad actual, explica el 59 %
de la variación en 2024, que es justamente lo que logra la persistencia. Para tener una referencia de cómo se
vería una fuga, construimos a propósito una variable que no debería estar disponible: la velocidad de la hora
t + 23, la anterior al objetivo. Sola alcanza un R² = 0.85.
No hay objetivos de entrenamiento dentro de 2025 ni filas duplicadas. El 92 % de las filas de prueba
corresponde a estaciones que también están en el entrenamiento, lo cual es normal en un pronóstico temporal,
donde se predice el futuro de estaciones conocidas; la generalización a estaciones nuevas la evaluamos aparte
con GroupKFold. No descartamos ninguna variable por fuga; la categoría de la estación queda fuera por tener
categorías demasiado raras (sección 2.2).
dups = PT.duplicated(["est", "hora"]).sum()
huecos = PT.sort_values(["est", "hora"]).groupby("est").hora.diff().dt.total_seconds().div(3600).dropna()
huecos = huecos[huecos > 1]
h_vel = PT.groupby(PT.hora.dt.hour).vel.median().idxmax()
h_tmp = PT.groupby(PT.hora.dt.hour).temp.median().idxmax()
print(f"Zona horaria: la temperatura mediana es máxima a las {h_tmp} h y el viento a las {h_vel} h. En hora local "
      "ambos máximos se esperan a primera hora de la tarde; si las marcas estuvieran en UTC aparecerían 5 h más "
      "tarde (18–20 h). Suponemos hora local de Colombia (UTC−5, sin horario de verano); la fuente no especifica "
      "la zona horaria.")
print("Frecuencia: horaria regular")
print(f"Marcas de tiempo duplicadas (estación, hora): {dups}")
print(f"Huecos (> 1 h) dentro de cada estación: {len(huecos):,} | mediana {huecos.median():.0f} h | "
      f"p90 {huecos.quantile(.9):.0f} h | máx {huecos.max() / 24:.0f} días")
cob = pd.read_csv(DATOS / "cobertura_velocidad.csv", dtype={"CodigoEstacion": str}).set_index(["CodigoEstacion", "nombre", "depto"])
fig, ax = plt.subplots(figsize=(10, 12))
horas_anio = pd.Series({c: 8784 if int(c) % 4 == 0 else 8760 for c in cob.columns})  # 2020 y 2024 son bisiestos
sns.heatmap(cob.sort_values("2024", ascending=False).div(horas_anio), cmap="viridis", vmin=0, vmax=1, ax=ax,
            yticklabels=[n for _, n, _ in cob.sort_values("2024", ascending=False).index],
            cbar_kws={"label": "fracción del año con dato"})
ax.set(title="Cobertura de velocidad por estación y año", xlabel="año", ylabel="")
ax.tick_params(axis="y", labelsize=6)
fig.tight_layout(); plt.show()
Zona horaria: la temperatura mediana es máxima a las 13 h y el viento a las 14 h. En hora local ambos máximos se esperan a primera hora de la tarde; si las marcas estuvieran en UTC aparecerían 5 h más tarde (18–20 h). Suponemos hora local de Colombia (UTC−5, sin horario de verano); la fuente no especifica la zona horaria.
Frecuencia: horaria regular
Marcas de tiempo duplicadas (estación, hora): 0
Huecos (> 1 h) dentro de cada estación: 22,337 | mediana 3 h | p90 19 h | máx 1563 días
2.6.2 Serie completa, agregaciones y estacionalidad
fig, axs = plt.subplots(3, 1, figsize=(15, 10))
diaria = PT.groupby(PT.hora.dt.floor("D")).vel.mean()
semanal = diaria.resample("W").mean()
axs[0].plot(diaria.index, diaria, lw=.5, color="lightsteelblue", label="media diaria de la red")
axs[0].plot(semanal.index, semanal, lw=1.2, color="steelblue", label="media semanal")
axs[0].plot(diaria.rolling(30, center=True).mean(), color="darkorange", lw=2, label="media móvil 30 días")
axs[0].set(title="Velocidad media de la red, 2020–2024 (diaria, semanal y móvil de 30 días)", ylabel="m/s")
axs[0].legend(ncol=3)
mensual = PT.groupby([PT.hora.dt.to_period("M").dt.to_timestamp(), "depto"]).vel.mean().unstack()
mensual.plot(ax=axs[1], lw=1.5)
axs[1].set(title="Media mensual por departamento", ylabel="m/s", xlabel=""); axs[1].legend(ncol=4, fontsize=8)
sub = muestra(PT, 300000)
sns.boxplot(x=sub.hora.dt.dayofweek, y=sub.vel, ax=axs[2], showfliers=False, color="lightsteelblue")
axs[2].set(title="Velocidad por día de la semana (0 = lunes)", xlabel="", ylabel="m/s")
fig.tight_layout(); plt.show()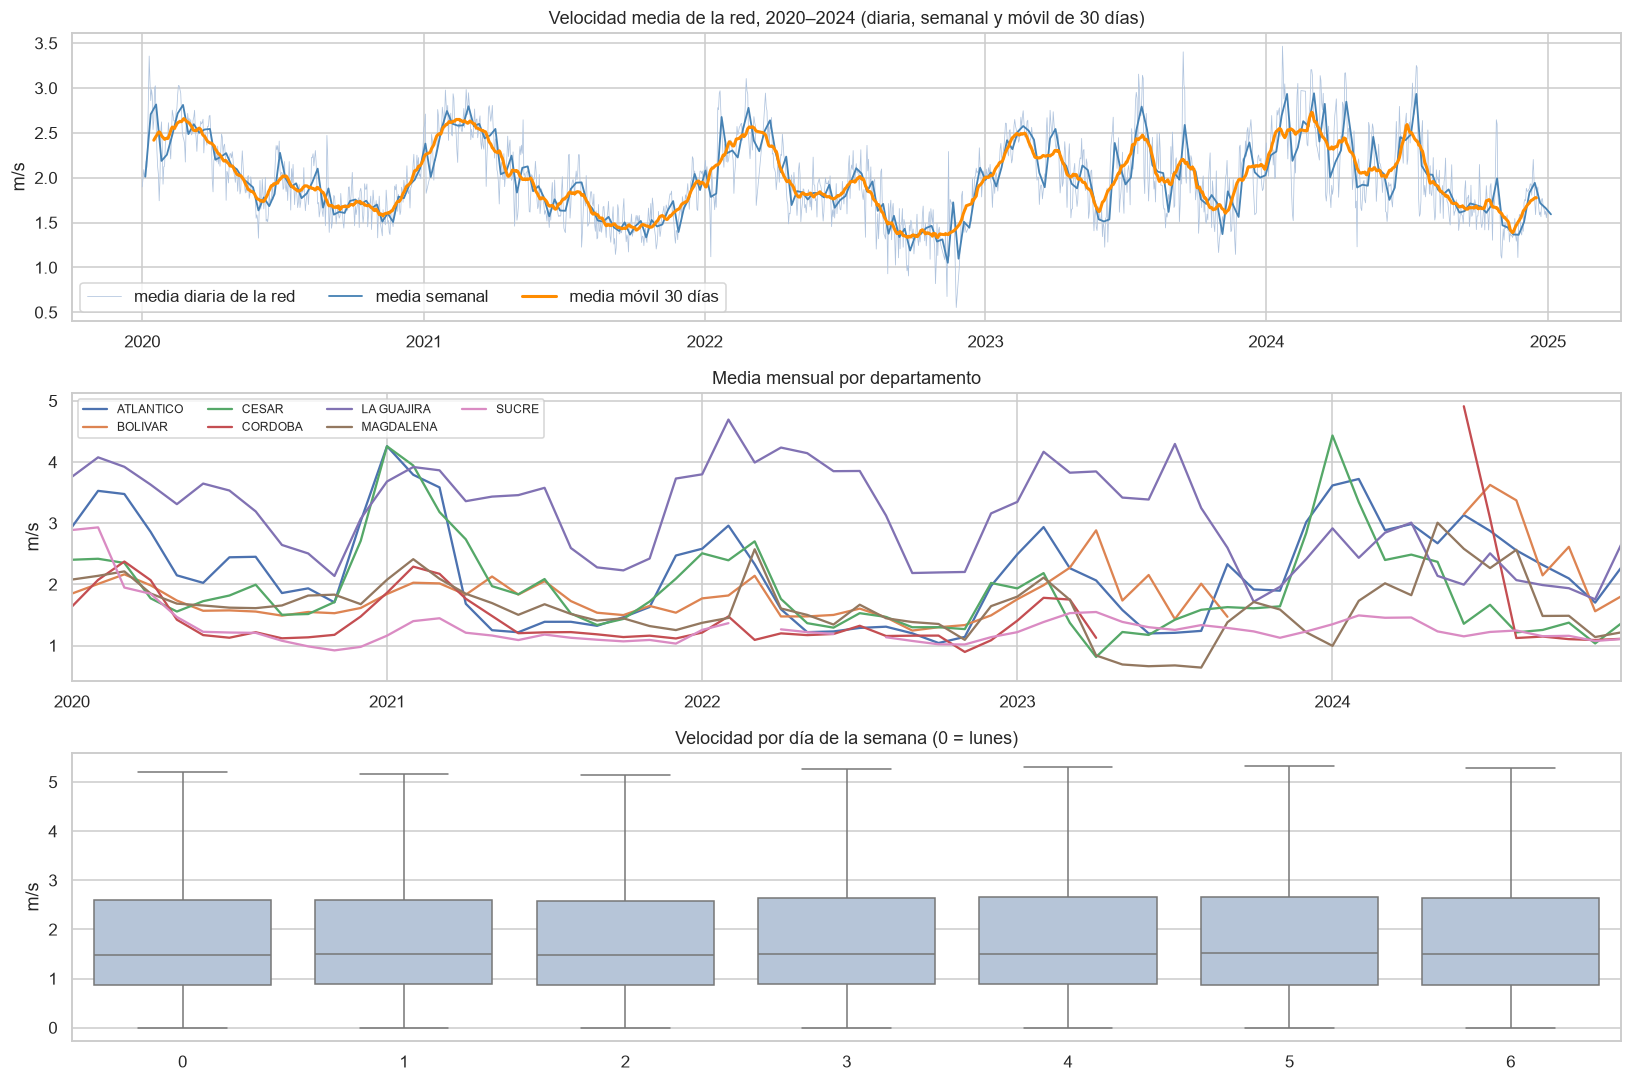
Cambios de régimen, eventos y calendario. Como la red cambia de un mes a otro, un promedio simple podría mostrar “cambios” que solo reflejan qué estaciones reportaron. Para evitarlo calculamos la anomalía de cada estación respecto a su propia climatología mensual (su media de ese mes en 2020–2024) y promediamos las anomalías de las estaciones presentes; así, una estación ventosa que entra o sale de la red no desplaza el promedio. Solo usamos meses con al menos 15 estaciones, y el gráfico muestra cuántas aporta cada mes.
Sobre esa serie aplicamos la prueba de Pettitt y marcamos los eventos ENSO del periodo según el Índice Oceánico El Niño (ONI) de la NOAA: La Niña, de mediados de 2020 a inicios de 2023, y El Niño, de mediados de 2023 a mediados de 2024. No analizamos los feriados por separado, porque el viento es una variable física y el día de la semana no muestra ningún efecto.
def pettitt(x):
    x = np.asarray(x, float)
    n = len(x)
    U = np.array([np.sign(x[t + 1:, None] - x[None, :t + 1]).sum() for t in range(n - 1)])
    k = np.argmax(np.abs(U))
    K = np.abs(U[k])
    return k, K, min(1.0, 2 * np.exp(-6 * K ** 2 / (n ** 3 + n ** 2)))


# media mensual por estación (solo meses con al menos 15 días con dato) y anomalía respecto a su climatología
dias_mes = PT.groupby([PT.hora.dt.to_period("M"), "est"]).hora.apply(lambda h: h.dt.day.nunique()).unstack()
men = PT.groupby([PT.hora.dt.to_period("M"), "est"]).vel.mean().unstack().where(dias_mes >= 15)
clim_est = men.groupby(men.index.month).transform("mean")
anom_est = men - clim_est
n_est_mes = anom_est.notna().sum(axis=1)
anom_red = anom_est.mean(axis=1)[n_est_mes >= 15]
presentes_siempre = anom_est.loc[anom_red.index].notna().all().sum()
k_cp, K_cp, p_cp = pettitt(anom_red.to_numpy())
fecha_cp = anom_red.index[k_cp + 1].to_timestamp()
fig, (ax, ax2) = plt.subplots(2, 1, figsize=(15, 5.5), sharex=True, gridspec_kw={"height_ratios": [3, 1]})
x_ = anom_red.index.to_timestamp()
ax.bar(x_, anom_red, width=20, color=np.where(anom_red > 0, "steelblue", "indianred"))
ax.axvspan(pd.Timestamp("2020-08-01"), pd.Timestamp("2023-02-28"), color="blue", alpha=.07, label="La Niña (ONI)")
ax.axvspan(pd.Timestamp("2023-06-01"), pd.Timestamp("2024-05-31"), color="red", alpha=.07, label="El Niño (ONI)")
ax.axvline(fecha_cp, color="k", ls="--", label=f"punto de cambio de Pettitt (p = {p_cp:.3f})")
ax.set(title="Anomalía mensual media de las estaciones (cada una respecto a su propia climatología)", ylabel="m/s")
ax.legend(loc="upper left", fontsize=8)
ax2.bar(x_, n_est_mes.loc[anom_red.index], width=20, color="gray")
ax2.set(ylabel="estaciones", title="Estaciones que aportan a cada mes")
fig.tight_layout(); plt.show()
print(f"Meses analizados: {len(anom_red)} | estaciones por mes: {n_est_mes.loc[anom_red.index].min()} a "
      f"{n_est_mes.loc[anom_red.index].max()} | estaciones presentes en todos esos meses: {presentes_siempre}")
media_antes, media_despues = anom_red[:k_cp + 1].mean(), anom_red[k_cp + 1:].mean()
print(f"Pettitt: cambio más probable en {fecha_cp:%Y-%m} (p = {p_cp:.3f}); "
      f"anomalía media antes {media_antes:+.2f} m/s y después {media_despues:+.2f} m/s")
enso = pd.Series(np.select([(x_ >= "2020-08-01") & (x_ <= "2023-02-28"), (x_ >= "2023-06-01") & (x_ <= "2024-05-31")],
                           ["La Niña", "El Niño"], "neutral"), index=anom_red.index)
print("Anomalía media por fase ENSO (m/s):", anom_red.groupby(enso).mean().round(3).to_dict())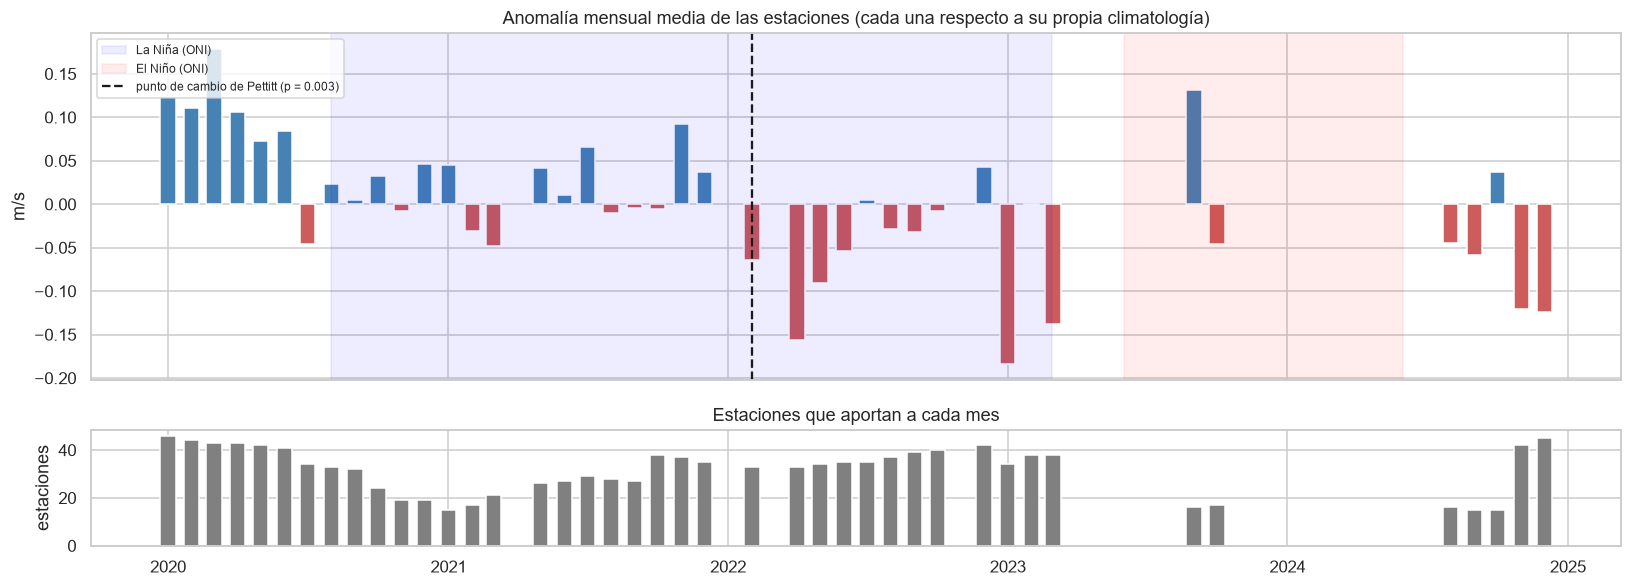
Meses analizados: 42 | estaciones por mes: 15 a 46 | estaciones presentes en todos esos meses: 1
Pettitt: cambio más probable en 2022-02 (p = 0.003); anomalía media antes +0.04 m/s y después -0.05 m/s
Anomalía media por fase ENSO (m/s): {'El Niño': 0.043, 'La Niña': -0.01, 'neutral': 0.014}
Con las anomalías por estación, la prueba de Pettitt señala un cambio en febrero de 2022 (p = 0.003), pero de
un tamaño despreciable: la anomalía media pasa de +0.04 m/s a −0.05 m/s. Las diferencias entre las fases de ENSO
también son mínimas (−0.01 m/s en La Niña y +0.04 m/s en El Niño). Al promediar directamente
la velocidad de toda la red aparece un cambio de +0.3 m/s en abril de 2023, que coincide con el paso de La
Niña a El Niño; ese cambio desaparece al controlar la composición de la red, de modo que se debe sobre todo a
qué estaciones reportaban cada mes.
Hay dos advertencias: solo 42 de los 60 meses tienen al menos 15 estaciones (y solo una estación aparece en todos ellos), y una estación que reporta solo parte del periodo absorbe en su propia climatología parte de la variación entre años. Con estos datos, entonces, no podemos afirmar ni descartar un efecto de ENSO. Para el modelado, no vemos un cambio de régimen que obligue a tratar los años por separado, y la variación entre años queda cubierta por la validación por periodos.
2.6.3 Descomposición, estacionariedad y dependencia temporal
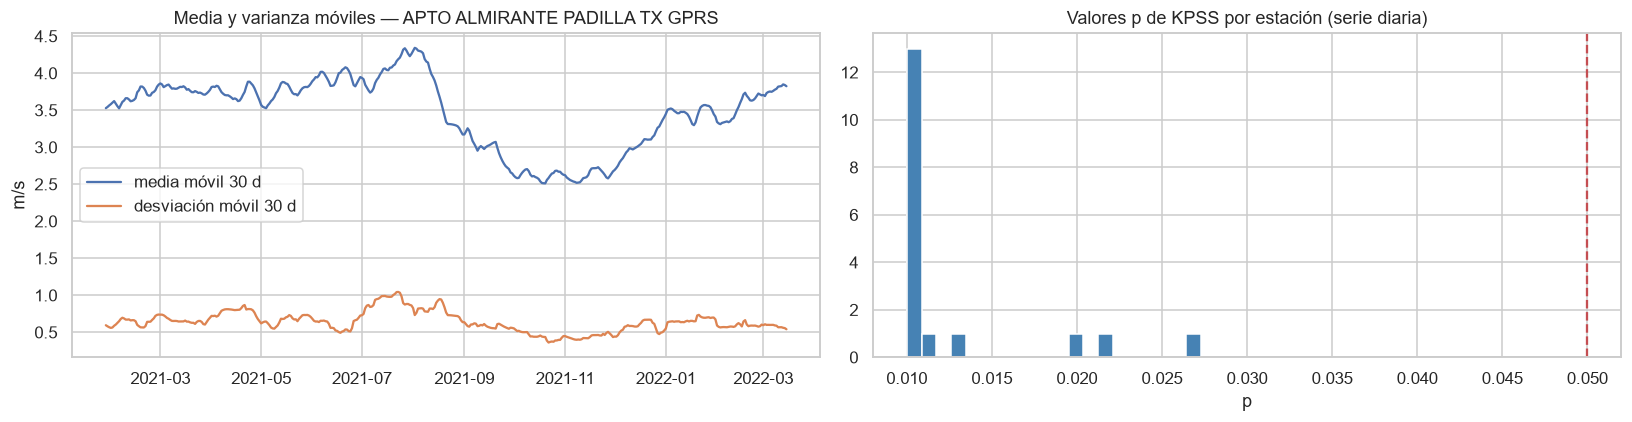
Usamos como ejemplo la estación con mejor cobertura en 2020–2024 y aplicamos las pruebas de estacionariedad a todas las estaciones con al menos un año continuo de datos diarios.
e_rep = PT.groupby("est").vel.count().idxmax()
nombre_rep = est.loc[e_rep, "nombre"]
s_h = G.loc[e_rep].vel
s_h = s_h[s_h.index < TEST_INI]
s_d = s_h.resample("D").mean().where(s_h.resample("D").count() >= 18)


def tramo_continuo(s, limite):
    s = s.interpolate(limit=limite, limit_area="inside")
    grupos = s.isna().cumsum()
    largo = s.notna().groupby(grupos).sum()
    return s[grupos == largo.idxmax()].dropna()


sd = tramo_continuo(s_d, 7)
stl = STL(sd, period=365, robust=True).fit()
fig = stl.plot(); fig.set_size_inches(14, 8)
fig.suptitle(f"STL de la velocidad media diaria — {nombre_rep} ({sd.index.min():%Y-%m} a {sd.index.max():%Y-%m})", y=1.01)
plt.show()
fuerza_est = max(0, 1 - stl.resid.var() / (stl.seasonal + stl.resid).var())
fuerza_ten = max(0, 1 - stl.resid.var() / (stl.trend + stl.resid).var())
print(f"Fuerza de la estacionalidad anual: {fuerza_est:.2f} | fuerza de la tendencia: {fuerza_ten:.2f}")

sh = tramo_continuo(s_h, 3).iloc[-24 * 60:]
stl_h = STL(sh, period=24, robust=True).fit()
print(f"Fuerza del ciclo diario (60 días horarios): "
      f"{max(0, 1 - stl_h.resid.var() / (stl_h.seasonal + stl_h.resid).var()):.2f}")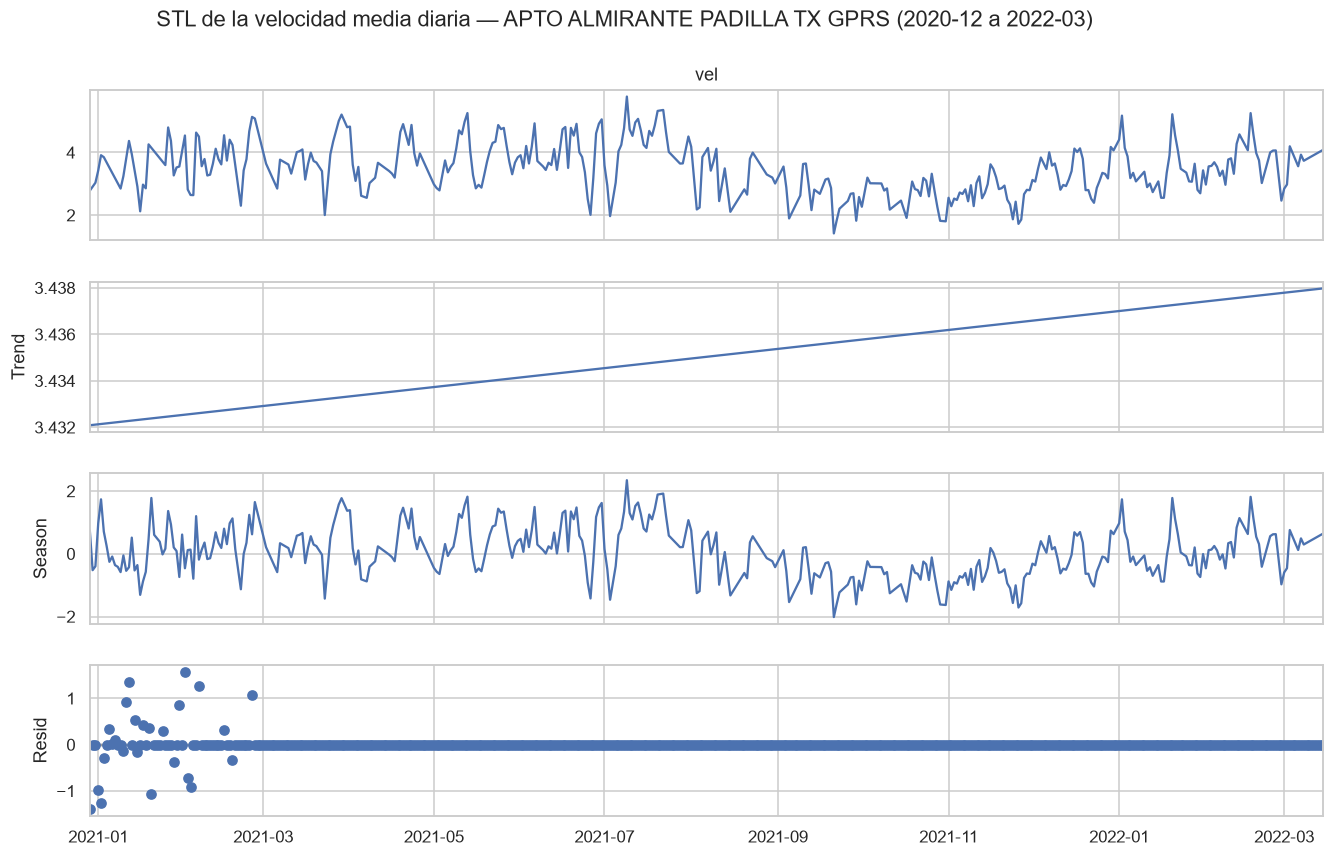
Fuerza de la estacionalidad anual: 0.94 | fuerza de la tendencia: 0.00
Fuerza del ciclo diario (60 días horarios): 0.83
fig, axs = plt.subplots(1, 2, figsize=(15, 4))
axs[0].plot(sd.rolling(30).mean(), label="media móvil 30 d")
axs[0].plot(sd.rolling(30).std(), label="desviación móvil 30 d")
axs[0].set(title=f"Media y varianza móviles — {nombre_rep}", ylabel="m/s"); axs[0].legend()
res = []
for e_, g in PT.groupby("est"):
    s = g.set_index("hora").vel.resample("D").mean()
    s = s.where(g.set_index("hora").vel.resample("D").count() >= 18)
    s = tramo_continuo(s, 7) if s.notna().sum() > 30 else pd.Series(dtype=float)
    if len(s) < 365:
        continue
    anom_s = s - s.groupby(s.index.month).transform("mean")  # sin el ciclo anual (media por mes)
    res.append({"est": e_, "días": len(s), "p ADF": adfuller(s, autolag="AIC")[1],
                "p KPSS": kpss(s, regression="c", nlags="auto")[1],
                "p ADF (anomalía)": adfuller(anom_s, autolag="AIC")[1],
                "p KPSS (anomalía)": kpss(anom_s, regression="c", nlags="auto")[1]})
est_test = pd.DataFrame(res)
resumen_est = pd.DataFrame({
    "serie original": [100 * (est_test["p ADF"] < .05).mean(), 100 * (est_test["p KPSS"] > .05).mean()],
    "sin ciclo anual": [100 * (est_test["p ADF (anomalía)"] < .05).mean(), 100 * (est_test["p KPSS (anomalía)"] > .05).mean()],
}, index=["% estaciones estacionarias según ADF (p < 0.05)", "% estacionarias según KPSS (p > 0.05)"]).round(1)
print(f"Estaciones con ≥ 365 días continuos: {len(est_test)}")
display(resumen_est)
axs[1].hist(est_test["p KPSS"], bins=20, color="steelblue")
axs[1].axvline(.05, c="r", ls="--"); axs[1].set(title="Valores p de KPSS por estación (serie diaria)", xlabel="p")
fig.tight_layout(); plt.show()
Estaciones con ≥ 365 días continuos: 18
shc = tramo_continuo(s_h, 3)
fig, axs = plt.subplots(1, 3, figsize=(17, 4))
axs[0].stem(acf(shc, nlags=72), markerfmt=" ")
axs[0].set(title=f"ACF horaria — {nombre_rep}", xlabel="rezago (h)")
axs[1].stem(pacf(shc, nlags=72, method="ywm"), markerfmt=" ")
axs[1].set(title="PACF horaria", xlabel="rezago (h)")
# correlación de X(t) con vel(t + k), buscando vel(t + k) por fecha exacta en la rejilla horaria
# (no por posición de fila: con huecos, k filas no son k horas)
lags = list(range(0, 49, 4))
base_cc = muestra(TR, 200000)
cc = {v: [] for v in ["vel_l0", "temp", "pres", "u", "w", "vel_vecinos"]}
for k in lags:
    b_k = base_cc[base_cc.t + pd.Timedelta(k, "h") < TEST_INI]  # nunca consultar datos de 2025
    yk = pd.Series(G.vel.reindex(pd.MultiIndex.from_arrays([b_k.est, b_k.t + pd.Timedelta(k, "h")])).to_numpy())
    for v in cc:
        cc[v].append(pd.Series(b_k[v].to_numpy()).corr(yk))
for v, c in cc.items():
    axs[2].plot(lags, c, "o-", ms=3, label=v)
axs[2].set(title="Correlación de X(t) con vel(t+k)", xlabel="k (h)"); axs[2].legend(fontsize=8)
fig.tight_layout(); plt.show()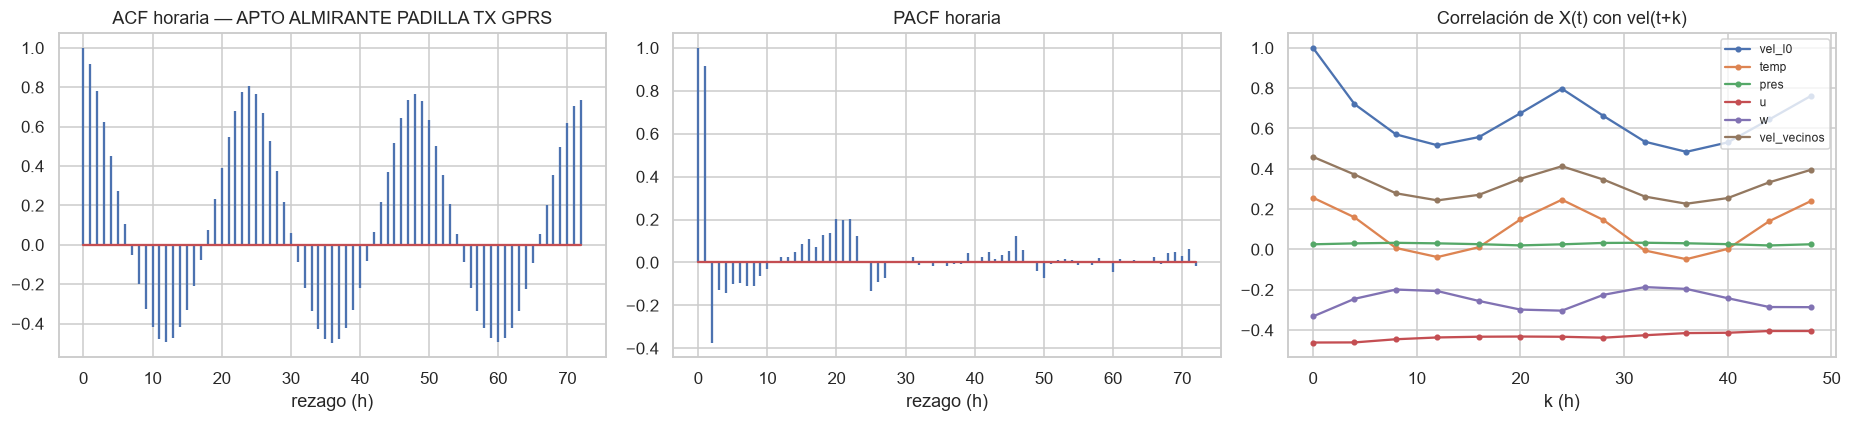
2.6.4 Deriva temporal y heterogeneidad entre estaciones
deriva = []
for v in ["vel", "temp", "pres", "dir_constancia"]:
    base = muestra(PT[PT.anio == 2020][v].dropna(), 20000)
    for a in range(2021, 2025):
        otro = muestra(PT[PT.anio == a][v].dropna(), 20000)
        deriva.append({"variable": v, "año": a, "KS vs. 2020": stats.ks_2samp(base, otro).statistic})
deriva = pd.DataFrame(deriva).pivot(index="variable", columns="año", values="KS vs. 2020")
concepto = TR.groupby(TR.t.dt.year)[["vel_l0", "y"]].apply(lambda g: g.corr().iloc[0, 1]).rename("corr(vel_t, vel_t+24)")
display(deriva.round(3)); print(concepto.round(3).to_string())

fig, axs = plt.subplots(1, 2, figsize=(14, 4))
sns.histplot(perfil.vel_media, bins=20, ax=axs[0], color="steelblue")
axs[0].set(title="Velocidad media por estación", xlabel="m/s")
sns.histplot(perfil.amplitud_diaria, bins=20, ax=axs[1], color="darkorange")
axs[1].set(title="Amplitud del ciclo diario por estación", xlabel="m/s")
fig.tight_layout(); plt.show()t
2020 0.761
2021 0.759
2022 0.885
2023 0.838
2024 0.771
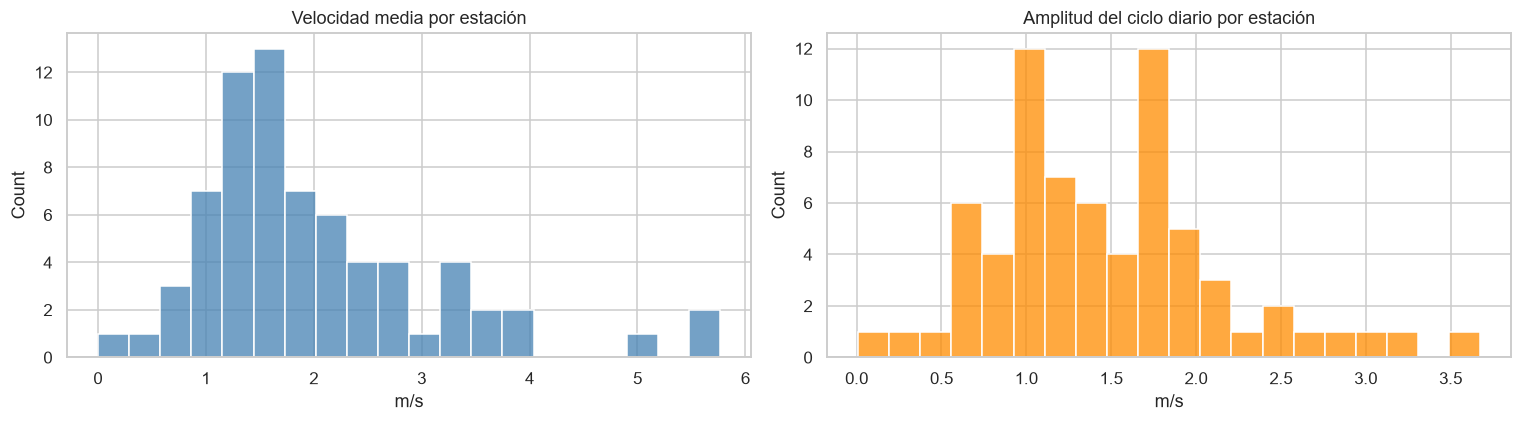
La frecuencia es horaria y regular, sin marcas de tiempo duplicadas. La fuente no indica la zona horaria, pero el ciclo diario de la temperatura y del viento solo tiene sentido en hora local, así que trabajamos con ese supuesto. Hay unos 22 000 huecos, casi todos cortos (la mediana es de 3 h), aunque algunas estaciones dejan de reportar durante meses o años; por eso los rezagos se construyen sobre la rejilla horaria real, donde un hueco queda como NaN y nunca se toma otra fecha en su lugar.
En la estación de ejemplo, el ciclo diario explica el 83 % de la variación horaria sin tendencia y el ciclo
anual el 94 % de la variación diaria, mientras que la tendencia en 2020–2024 es nula. El día de la semana no
influye, como cabe esperar de una variable física.
En las series diarias originales, KPSS rechaza la estacionariedad en todas las estaciones analizadas y ADF
solo la respalda en un tercio: la media cambia con la temporada. Una vez quitado el ciclo anual, ADF rechaza
la raíz unitaria en el 100 % de las estaciones y KPSS no rechaza la estacionariedad en el 67 %. Las series
parecen, por tanto, estacionarias alrededor de su ciclo estacional, aunque la prueba solo cubre las 18
estaciones con al menos un año continuo. Esto respalda incluir el día del año como predictora.
La ACF oscila con un periodo de 24 h y la PACF tiene picos en 1 h y alrededor de 24 h. La correlación entre la
velocidad actual y la velocidad k horas después (calculada por fecha exacta) baja hasta k ≈ 12 h y vuelve a
subir en k = 24 h: para pronosticar a un día, lo más informativo es la velocidad de hoy a la misma hora y la de
las horas previas. La componente u (viento del este) y la velocidad de los vecinos mantienen una correlación
estable con el viento futuro.
Los cambios de distribución entre años son pequeños (KS ≤ 0.14); los mayores aparecen en la presión y la
temperatura en 2023–2024, cuando cambió la red de estaciones. La relación entre la velocidad de hoy y la de
mañana también varía entre años (r entre 0.76 y 0.89), una forma leve de concept drift que la validación por
periodos permite medir. Por último, las estaciones son muy distintas entre sí: la velocidad media va de menos de
1 a más de 5 m/s, y la amplitud del ciclo diario de menos de 0.5 a más de 3 m/s.
print("Sistema de referencia: EPSG:4326 (WGS84, grados), el del catálogo del IDEAM")
print(f"Latitud: {est.lat.min():.3f} a {est.lat.max():.3f} | longitud: {est.lon.min():.3f} a {est.lon.max():.3f}")
print(f"Coordenadas fuera de rango válido: {(~est.lat.between(-90, 90) | ~est.lon.between(-180, 180)).sum()} | "
      f"(0, 0): {((est.lat == 0) & (est.lon == 0)).sum()} | posibles lat/lon invertidas: {(est.lat.abs() > est.lon.abs()).sum()}")
print(f"Estaciones con coordenadas duplicadas: {est.duplicated(['lat', 'lon']).sum()}")
fuera_deptos = (~est.depto.isin(["ATLANTICO", "BOLIVAR", "CESAR", "CORDOBA", "LA GUAJIRA", "MAGDALENA", "SUCRE"])).sum()
print(f"Caja envolvente de las estaciones: lat {est.lat.min():.2f}–{est.lat.max():.2f} °N, "
      f"lon {est.lon.min():.2f}–{est.lon.max():.2f} °. Estaciones con departamento fuera de los 7 seleccionados: {fuera_deptos}.")
sur = est[est.lat < 8]
print(f"Estaciones al sur de 8 °N (sur de Bolívar y Córdoba, dentro de los departamentos): {len(sur)} — "
      f"{', '.join(sur.nombre.str.strip() + ' (' + sur.depto + ')')}")
Sistema de referencia: EPSG:4326 (WGS84, grados), el del catálogo del IDEAM
Latitud: 7.475 a 12.339 | longitud: -76.224 a -71.211
Coordenadas fuera de rango válido: 0 | (0, 0): 0 | posibles lat/lon invertidas: 0
Estaciones con coordenadas duplicadas: 1
Caja envolvente de las estaciones: lat 7.47–12.34 °N, lon -76.22–-71.21 °. Estaciones con departamento fuera de los 7 seleccionados: 0.
Estaciones al sur de 8 °N (sur de Bolívar y Córdoba, dentro de los departamentos): 4 — COLEGIO COOPERATIVO (BOLIVAR), CANELOS - AUT (BOLIVAR), PUERTO LIBERTADOR (CORDOBA), JUAN JOSE - AUT (CORDOBA)
2.7.2 Mapas, patrón de puntos y cobertura
lat0 = np.deg2rad(est.lat.mean())
xk = 6371 * np.deg2rad(est.lon) * np.cos(lat0)
yk = 6371 * np.deg2rad(est.lat)
area = ConvexHull(np.column_stack([xk, yk])).volume  # en 2D, 'volume' es el área (km²)
nn = np.sort(np.where(np.eye(len(DIST)) == 1, np.inf, DIST), axis=1)[:, 0]
R_ce = nn.mean() / (0.5 / np.sqrt(len(est) / area))
print(f"Distancia al vecino más cercano: mediana {np.median(nn):.1f} km, máx {nn.max():.1f} km")
print(f"Índice de Clark-Evans R = {R_ce:.2f} (R < 1 agrupado, R ≈ 1 aleatorio, R > 1 regular) | área de estudio ≈ {area:,.0f} km²")

# función K de Ripley (estimador sin corrección de borde) y su versión L(r) − r; bajo CSR, L(r) − r ≈ 0
xy = np.column_stack([xk, yk])
dxy = np.sqrt(((xy[:, None] - xy[None]) ** 2).sum(-1))
np.fill_diagonal(dxy, np.inf)
radios = np.arange(5, 155, 5)
n_e = len(xy)
K_r = np.array([area / (n_e * (n_e - 1)) * (dxy < r).sum() for r in radios])
L_r = np.sqrt(K_r / np.pi) - radios
# envolvente de CSR con la MISMA ventana y el mismo estimador que los datos: puntos uniformes dentro del
# polígono convexo de las estaciones (muestreo por rechazo) y su misma área
from matplotlib.path import Path as Trazado
casco = ConvexHull(xy)
ventana = Trazado(xy[casco.vertices])
sims = []
for _ in range(99):
    xs = np.empty((0, 2))
    while len(xs) < n_e:
        cand = np.column_stack([RNG.uniform(xk.min(), xk.max(), 4 * n_e), RNG.uniform(yk.min(), yk.max(), 4 * n_e)])
        xs = np.vstack([xs, cand[ventana.contains_points(cand)]])
    xs = xs[:n_e]
    ds = np.sqrt(((xs[:, None] - xs[None]) ** 2).sum(-1)); np.fill_diagonal(ds, np.inf)
    sims.append(np.sqrt(np.array([area / (n_e * (n_e - 1)) * (ds < r).sum() for r in radios]) / np.pi) - radios)
sims = np.array(sims)
fuera = radios[(L_r < sims.min(0)) | (L_r > sims.max(0))]
print(f"Ripley: radios donde la curva observada sale de la envolvente CSR: "
      f"{', '.join(map(str, fuera)) + ' km' if len(fuera) else 'ninguno'}")

# clusters espaciales con DBSCAN (distancia haversine)
eps_km = 40
db = DBSCAN(eps=eps_km / 6371, min_samples=3, metric="haversine").fit(np.deg2rad(est[["lat", "lon"]].to_numpy()))
est["cluster_dbscan"] = db.labels_
print(f"DBSCAN (eps = {eps_km} km, mínimo 3 estaciones): {len(set(db.labels_) - {-1})} clusters; "
      f"{(db.labels_ == -1).sum()} estaciones aisladas (ruido)")

fig, axs = plt.subplots(1, 2, figsize=(16, 5))
axs[0].fill_between(radios, sims.min(0), sims.max(0), color="gray", alpha=.3, label="envolvente CSR (99 simulaciones)")
axs[0].plot(radios, L_r, "o-", color="steelblue", label="estaciones")
axs[0].axhline(0, c="k", lw=.6)
axs[0].set(title="Función L de Ripley: L(r) − r", xlabel="r (km)", ylabel="L(r) − r (km)"); axs[0].legend()
mapa_base(axs[1])
for c_, g in est.groupby("cluster_dbscan"):
    axs[1].scatter(g.lon, g.lat, s=45, edgecolor="k", lw=.3, label="aislada" if c_ == -1 else f"cluster {c_}",
                   color="lightgray" if c_ == -1 else None)
axs[1].set(title=f"Clusters espaciales de estaciones (DBSCAN haversine, eps = {eps_km} km)", xlabel="longitud", ylabel="latitud")
axs[1].legend(fontsize=7, ncol=2)
fig.tight_layout(); plt.show()

fig, axs = plt.subplots(1, 3, figsize=(20, 6.5))
mapa_base(axs[0], nombres=True)
sc = axs[0].scatter(est.lon, est.lat, c=est.vel_media, s=est.horas / est.horas.max() * 250 + 20, cmap="viridis",
                    edgecolor="k", lw=.4, zorder=2)
plt.colorbar(sc, ax=axs[0], label="velocidad media (m/s)", shrink=.8)
axs[0].set(title="Estaciones sobre el mapa base\n(tamaño = horas con dato; color = velocidad media)",
           xlabel="longitud", ylabel="latitud")
mapa_base(axs[1])
hb = axs[1].hexbin(est.lon, est.lat, gridsize=12, cmap="Oranges", mincnt=1, alpha=.85, zorder=2)
plt.colorbar(hb, ax=axs[1], label="estaciones por celda", shrink=.8)
axs[1].set(title="Densidad de estaciones (hexbin)", xlabel="longitud", ylabel="latitud")
# coropleta: velocidad media por departamento (media de sus estaciones, 2020–2024)
por_dep = est.dropna(subset=["vel_media"]).groupby("depto").vel_media.mean().to_dict()
mapa_base(axs[2], valores=por_dep, cmap="viridis", etiqueta="velocidad media de sus estaciones (m/s)", nombres=True)
axs[2].scatter(est.lon, est.lat, s=6, c="k", zorder=2)
axs[2].set(title="Coropleta por departamento", xlabel="longitud", ylabel="latitud")
fig.tight_layout(); plt.show()
print("Mapa base: límites departamentales de geoBoundaries (fuente OpenStreetMap, licencia ODbL 1.0).")
print("Velocidad media por departamento (m/s):", {k: round(v, 2) for k, v in sorted(por_dep.items(), key=lambda x: -x[1])})
Distancia al vecino más cercano: mediana 25.6 km, máx 77.5 km
Índice de Clark-Evans R = 1.16 (R < 1 agrupado, R ≈ 1 aleatorio, R > 1 regular) | área de estudio ≈ 154,748 km²
Ripley: radios donde la curva observada sale de la envolvente CSR: ninguno
DBSCAN (eps = 40 km, mínimo 3 estaciones): 7 clusters; 21 estaciones aisladas (ruido)
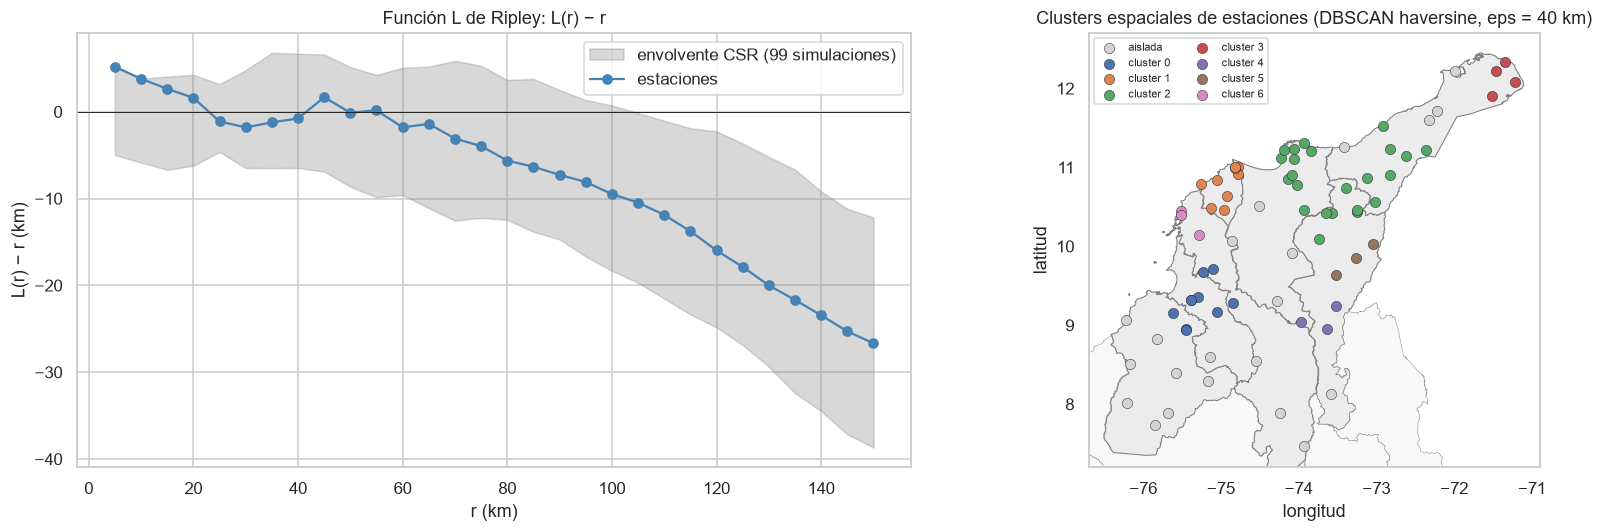
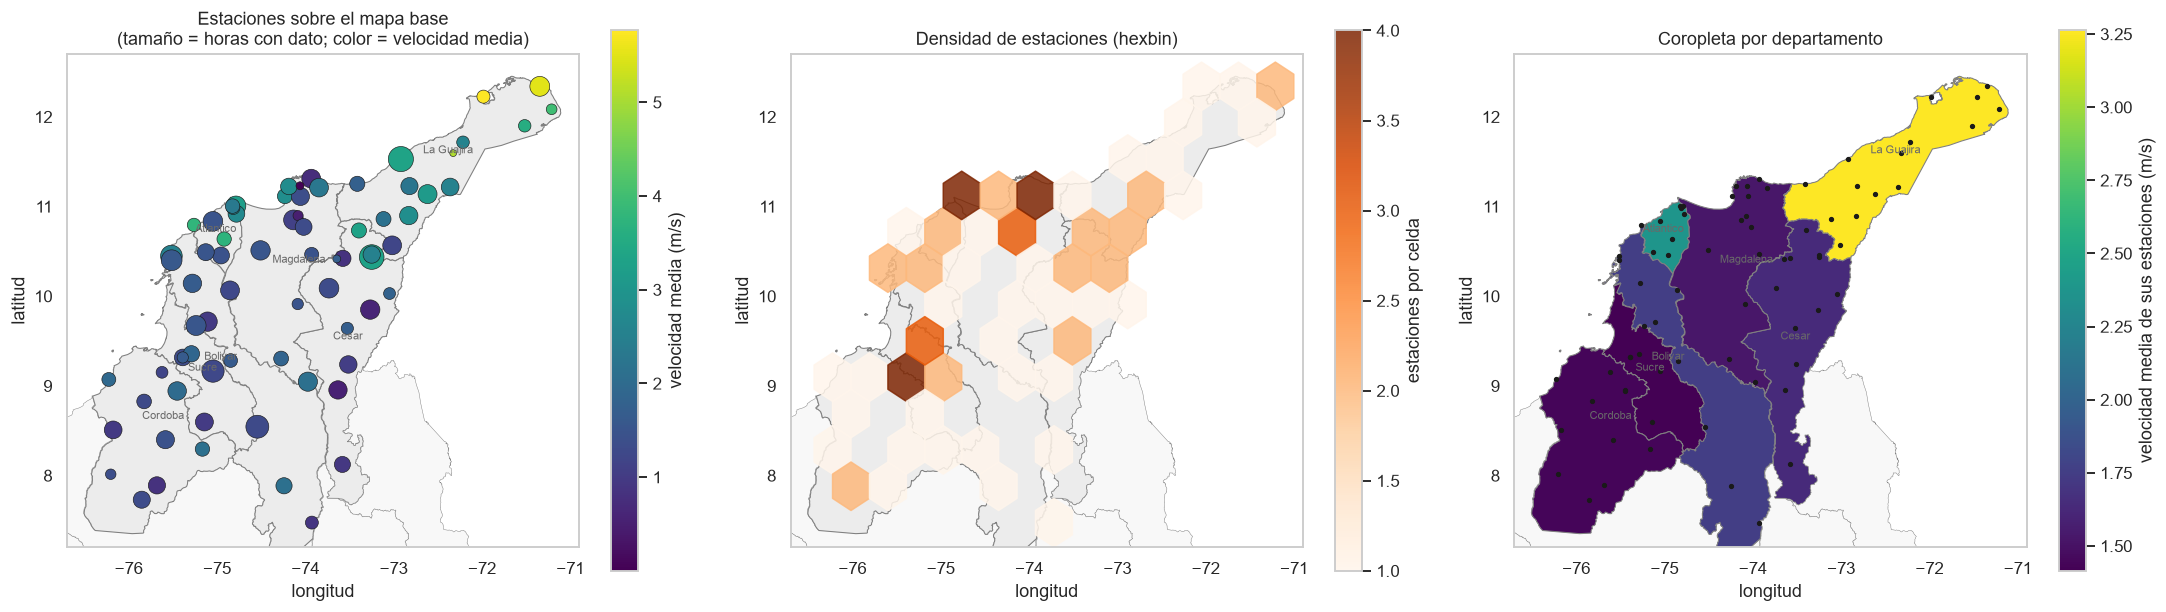
Mapa base: límites departamentales de geoBoundaries (fuente OpenStreetMap, licencia ODbL 1.0).
Velocidad media por departamento (m/s): {'LA GUAJIRA': 3.26, 'ATLANTICO': 2.38, 'BOLIVAR': 1.75, 'CESAR': 1.63, 'MAGDALENA': 1.53, 'CORDOBA': 1.44, 'SUCRE': 1.42}
2.7.3 Autocorrelación espacial
Como matriz de pesos usamos los 4 vecinos más cercanos, estandarizada por filas. Preferimos k vecinos a una
banda de distancia fija porque la densidad de estaciones es muy desigual y, con una banda, las estaciones
aisladas de La Guajira quedarían sin vecinos.
e_ok = est.dropna(subset=["vel_media"])
W = pesos_knn(haversine_matriz(e_ok.lat.to_numpy(), e_ok.lon.to_numpy()))
I, p_I = moran_perm(e_ok.vel_media.to_numpy(), W)
print(f"I de Moran global (velocidad media por estación): I = {I:.3f}, p = {p_I:.3f} (esperado sin estructura: {-1 / (len(e_ok) - 1):.3f})")

z = e_ok.vel_media.to_numpy() - e_ok.vel_media.mean()
m2 = (z ** 2).mean()
lag = W @ z
Ii = z / m2 * lag
p_loc = []
for i in range(len(z)):
    otros = np.delete(z, i)
    sim = np.array([z[i] / m2 * (RNG.choice(otros, K_VECINOS, replace=False).mean()) for _ in range(999)])
    p_loc.append((np.sum(np.abs(sim) >= abs(Ii[i])) + 1) / 1000)
e_ok = e_ok.assign(I_local=Ii, p_local=p_loc,
                   cuadrante=np.select([(z > 0) & (lag > 0), (z < 0) & (lag < 0), (z > 0) & (lag < 0)],
                                       ["alto-alto", "bajo-bajo", "alto-bajo"], "bajo-alto"))
# 70+ pruebas locales simultáneas: se corrige con Benjamini-Hochberg (FDR)
e_ok["p_fdr"] = multipletests(e_ok.p_local, method="fdr_bh")[1]
print(f"Estaciones con p local < 0.05 sin corrección: {(e_ok.p_local < .05).sum()} | con FDR < 0.05: {(e_ok.p_fdr < .05).sum()}")
e_ok["LISA"] = np.where(e_ok.p_fdr < .05, e_ok.cuadrante, "no significativo")
print(e_ok.LISA.value_counts().to_string())

fig, axs = plt.subplots(1, 2, figsize=(16, 6))
colores = {"alto-alto": "red", "bajo-bajo": "blue", "alto-bajo": "pink", "bajo-alto": "lightblue", "no significativo": "lightgray"}
mapa_base(axs[0])
for k_, g in e_ok.groupby("LISA"):
    axs[0].scatter(g.lon, g.lat, c=colores[k_], label=k_, s=70, edgecolor="k", lw=.4)
axs[0].legend(); axs[0].set(title="LISA (FDR < 0.05): agrupamientos locales de velocidad media", xlabel="longitud", ylabel="latitud")

# semivariograma empírico
Dm = haversine_matriz(e_ok.lat.to_numpy(), e_ok.lon.to_numpy())
iu = np.triu_indices(len(e_ok), 1)
gam = 0.5 * (e_ok.vel_media.to_numpy()[:, None] - e_ok.vel_media.to_numpy())[iu] ** 2
dist_p = Dm[iu]
bins = np.arange(0, 400, 25)
vg = pd.DataFrame({"d": dist_p, "g": gam}).assign(b=pd.cut(dist_p, bins)).groupby("b", observed=True).agg(
    d=("d", "mean"), g=("g", "mean"), n=("g", "size"))
axs[1].plot(vg.d, vg.g, "o-")
axs[1].axhline(e_ok.vel_media.var(), ls="--", c="gray", label="varianza total")
axs[1].set(title="Semivariograma empírico de la velocidad media", xlabel="distancia (km)", ylabel="semivarianza (m²/s²)")
axs[1].legend()
fig.tight_layout(); plt.show()

# hotspots de Getis-Ord Gi* (k vecinos incluyendo la propia estación), con corrección FDR
x_g = e_ok.vel_media.to_numpy()
W_g = (W > 0).astype(float)
np.fill_diagonal(W_g, 1)
n_g, xbar, s_g = len(x_g), x_g.mean(), x_g.std()
wsum = W_g.sum(1)
gi = (W_g @ x_g - xbar * wsum) / (s_g * np.sqrt((n_g * (W_g ** 2).sum(1) - wsum ** 2) / (n_g - 1)))
p_gi = multipletests(2 * stats.norm.sf(np.abs(gi)), method="fdr_bh")[1]
e_ok["Gi*"] = np.where(p_gi < .05, np.where(gi > 0, "hotspot", "coldspot"), "no significativo")
print("Getis-Ord Gi* (FDR < 0.05):", e_ok["Gi*"].value_counts().to_dict())
print("Hotspots:", ", ".join(e_ok[e_ok["Gi*"] == "hotspot"].nombre.str.strip()))

# efecto de la escala de agregación (MAUP): la misma relación a distintas escalas espaciales
e_m = est.dropna(subset=["vel_media", "temp_media"])
por_depto = e_m.groupby("depto")[["vel_media", "temp_media", "altitud"]].mean()
mau = pd.DataFrame({
    "estación (n = %d)" % len(e_m): [stats.spearmanr(e_m.vel_media, e_m.temp_media)[0],
                                     stats.spearmanr(e_m.vel_media, e_m.altitud)[0]],
    "departamento (n = %d)" % len(por_depto): [stats.spearmanr(por_depto.vel_media, por_depto.temp_media)[0],
                                               stats.spearmanr(por_depto.vel_media, por_depto.altitud)[0]],
}, index=["Spearman(velocidad, temperatura)", "Spearman(velocidad, altitud)"])
print("Efecto de la escala de agregación (MAUP): correlaciones con estaciones vs. con medias por departamento")
mau
I de Moran global (velocidad media por estación): I = 0.449, p = 0.001 (esperado sin estructura: -0.014)
Estaciones con p local < 0.05 sin corrección: 8 | con FDR < 0.05: 5
LISA
no significativo    69
alto-alto            5
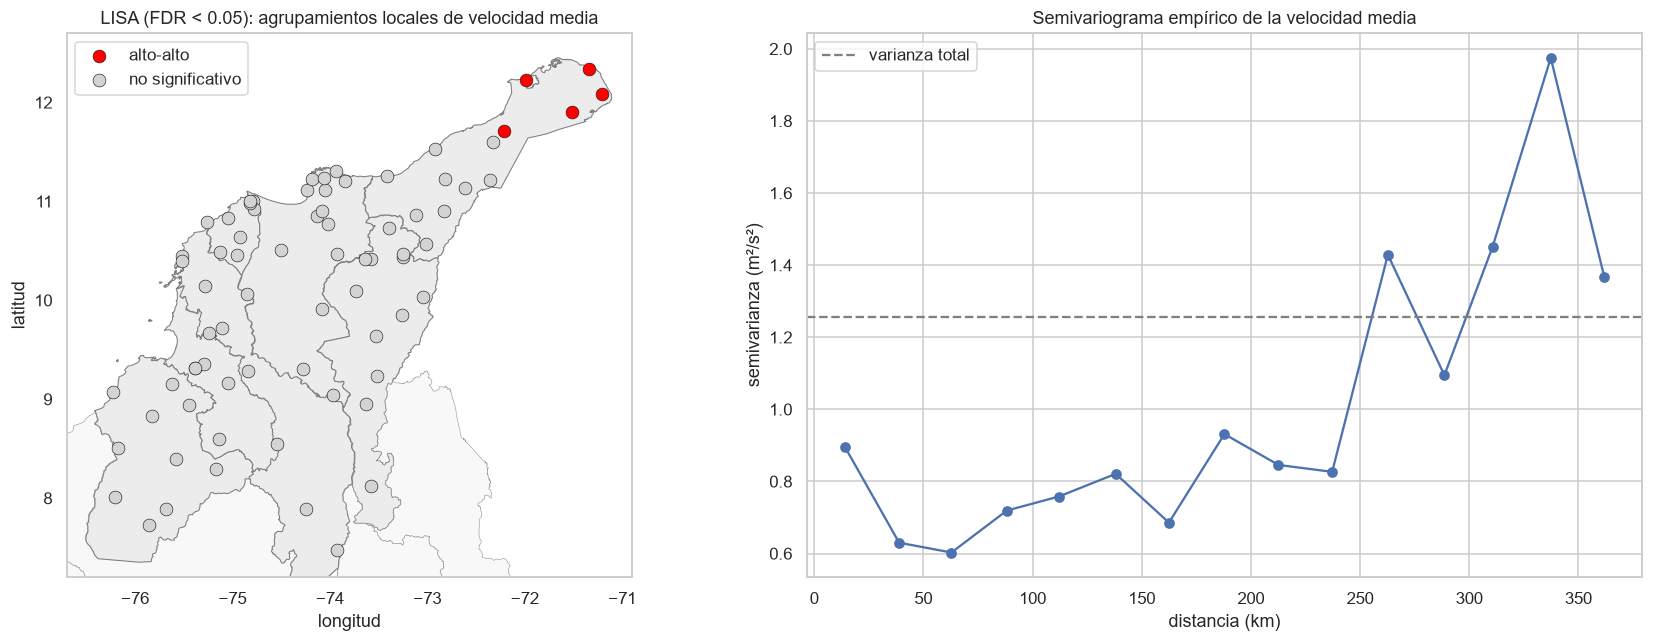
Getis-Ord Gi* (FDR < 0.05): {'no significativo': 69, 'hotspot': 5}
Hotspots: AEROPUERTO PUERTO BOLIVAR  - AUT, SILLAMANA, TOROMANA - AUT, IPICHIRRAIN, PUERTO ESTRELLA - AUT
Efecto de la escala de agregación (MAUP): correlaciones con estaciones vs. con medias por departamento
Todas las estaciones pertenecen a los siete departamentos seleccionados, y no hay coordenadas (0, 0) ni latitudes y longitudes invertidas. La caja envolvente llega hasta 7.5 °N porque el sur de Bolívar y de Córdoba se extiende por debajo de 8 °N. Dos estaciones comparten coordenadas, probablemente dos sensores del mismo sitio con códigos distintos, y las mantenemos como entidades separadas.
Sobre el mapa base se ve que casi todas las estaciones están en las tierras bajas y en la costa, con huecos en la Sierra Nevada, el interior de La Guajira y el sur de Bolívar. La coropleta pone a La Guajira muy por encima del resto, aunque un promedio por departamento mezcla sitios muy distintos, como costa y montaña; por eso el análisis se hace por estación (ver el efecto de la escala más abajo).
El índice de Clark-Evans sugiere un espaciamiento algo más regular que al azar (R = 1.16, sin prueba de
significancia), con una mediana de 26 km hasta el vecino más cercano. La función L de Ripley, calculada con la
misma ventana (el polígono convexo de las estaciones) para los datos y para las simulaciones, queda dentro de
la envolvente de aleatoriedad espacial completa entre 5 y 150 km, así que a esas escalas no hay evidencia de
agrupamiento ni de regularidad (el estimador no corrige el efecto de borde). DBSCAN, con distancia haversine y
un radio de 40 km, encuentra 7 grupos de estaciones cercanas y deja 21 aisladas, sobre todo en el sur de
Córdoba y Bolívar y en La Guajira, que son las zonas con menos cobertura.
La autocorrelación espacial es fuerte y significativa (I de Moran = 0.45, p = 0.001). Con corrección FDR por
las múltiples pruebas locales, el LISA encuentra un único agrupamiento, el de valores altos en La Guajira (5
estaciones; 8 sin corregir), y Getis-Ord Gi* señala el mismo hotspot en el norte de La Guajira (Puerto
Bolívar, Sillamana, Toromana, Ipichirrain y Puerto Estrella). Tomamos estos mapas locales como exploratorios.
El semivariograma crece con la distancia y alcanza la varianza total hacia los 250 km: las estaciones a menos
de unos 100 km tienen velocidades medias parecidas.
La escala de agregación también importa (el problema de la unidad de área modificable, MAUP): la correlación entre velocidad y temperatura cambia al pasar de estaciones a promedios por departamento (tabla anterior). Con solo siete departamentos las correlaciones agregadas son muy inestables y además mezclan costa y montaña, así que trabajamos siempre a escala de estación.
No usamos la latitud y la longitud crudas como predictoras: en un modelo lineal solo representarían un gradiente plano, y la información espacial ya entra por la altitud y por el rezago espacial. Tampoco usamos celdas H3 o geohash, porque con 76 estaciones casi todas las celdas tendrían una sola.
Como las estaciones vecinas se parecen, una validación al azar sería optimista. Por eso, además de
GroupKFold por estación, en la sección 3.2 evaluamos bloques geográficos con una zona de separación, y
usamos el promedio de los vecinos como predictora (rezago espacial).
2.8 Componente espacio-temporal
seca = PT.hora.dt.month.isin([12, 1, 2, 3, 4])
temporada = pd.DataFrame({"seca-ventosa (dic–abr)": PT[seca].groupby("est").vel.mean(),
                          "lluviosa (may–nov)": PT[~seca].groupby("est").vel.mean()}).join(est[["lat", "lon"]])
fig, axs = plt.subplots(1, 3, figsize=(19, 5.5))
vmax = temporada.iloc[:, :2].max().max()
for ax, c in zip(axs[:2], temporada.columns[:2]):
    mapa_base(ax)
    sc = ax.scatter(temporada.lon, temporada.lat, c=temporada[c], cmap="viridis", vmin=0, vmax=vmax, s=60, edgecolor="k", lw=.3)
    ax.set(title=f"Velocidad media — temporada {c}", xlabel="longitud", ylabel="latitud")
plt.colorbar(sc, ax=axs[1], label="m/s")
cambio = (temporada.iloc[:, 0] - temporada.iloc[:, 1])
t_ok = temporada.dropna()  # estaciones con datos en ambas temporadas
W_t = pesos_knn(haversine_matriz(t_ok.lat.to_numpy(), t_ok.lon.to_numpy()))
I_s, p_s = moran_perm(t_ok.iloc[:, 0].to_numpy(), W_t)
I_l, p_l = moran_perm(t_ok.iloc[:, 1].to_numpy(), W_t)
print(f"I de Moran: temporada seca {I_s:.3f} (p = {p_s:.3f}) | temporada lluviosa {I_l:.3f} (p = {p_l:.3f})")
print(f"Diferencia seca − lluviosa por estación: mediana {cambio.median():.2f} m/s; "
      f"{100 * (cambio > 0).mean():.0f} % de las estaciones es más ventosa en la temporada seca")

# decaimiento de la correlación temporal entre estaciones con la distancia
dia = PT.groupby(["est", PT.hora.dt.floor("D")]).vel.mean().unstack(0)
anom = dia - dia.groupby(dia.index.month).transform("mean")
C = anom.corr(min_periods=200)
ests = [e for e in C.index if e in est.index]
Dc = haversine_matriz(est.loc[ests, "lat"].to_numpy(), est.loc[ests, "lon"].to_numpy())
iu = np.triu_indices(len(ests), 1)
pares = pd.DataFrame({"d": Dc[iu], "r": C.loc[ests, ests].to_numpy()[iu]}).dropna()
pares["b"] = pd.cut(pares.d, np.arange(0, 450, 25))
dec = pares.groupby("b", observed=True).agg(d=("d", "mean"), r=("r", "median"))
axs[2].scatter(pares.d, pares.r, s=4, alpha=.3, color="gray")
axs[2].plot(dec.d, dec.r, "o-", color="darkorange", label="mediana por bloque de 25 km")
axs[2].set(title="Correlación de anomalías diarias entre pares de estaciones", xlabel="distancia (km)", ylabel="r")
axs[2].legend()
fig.tight_layout(); plt.show()
I de Moran: temporada seca 0.445 (p = 0.001) | temporada lluviosa 0.395 (p = 0.001)
Diferencia seca − lluviosa por estación: mediana 0.38 m/s; 82 % de las estaciones es más ventosa en la temporada seca
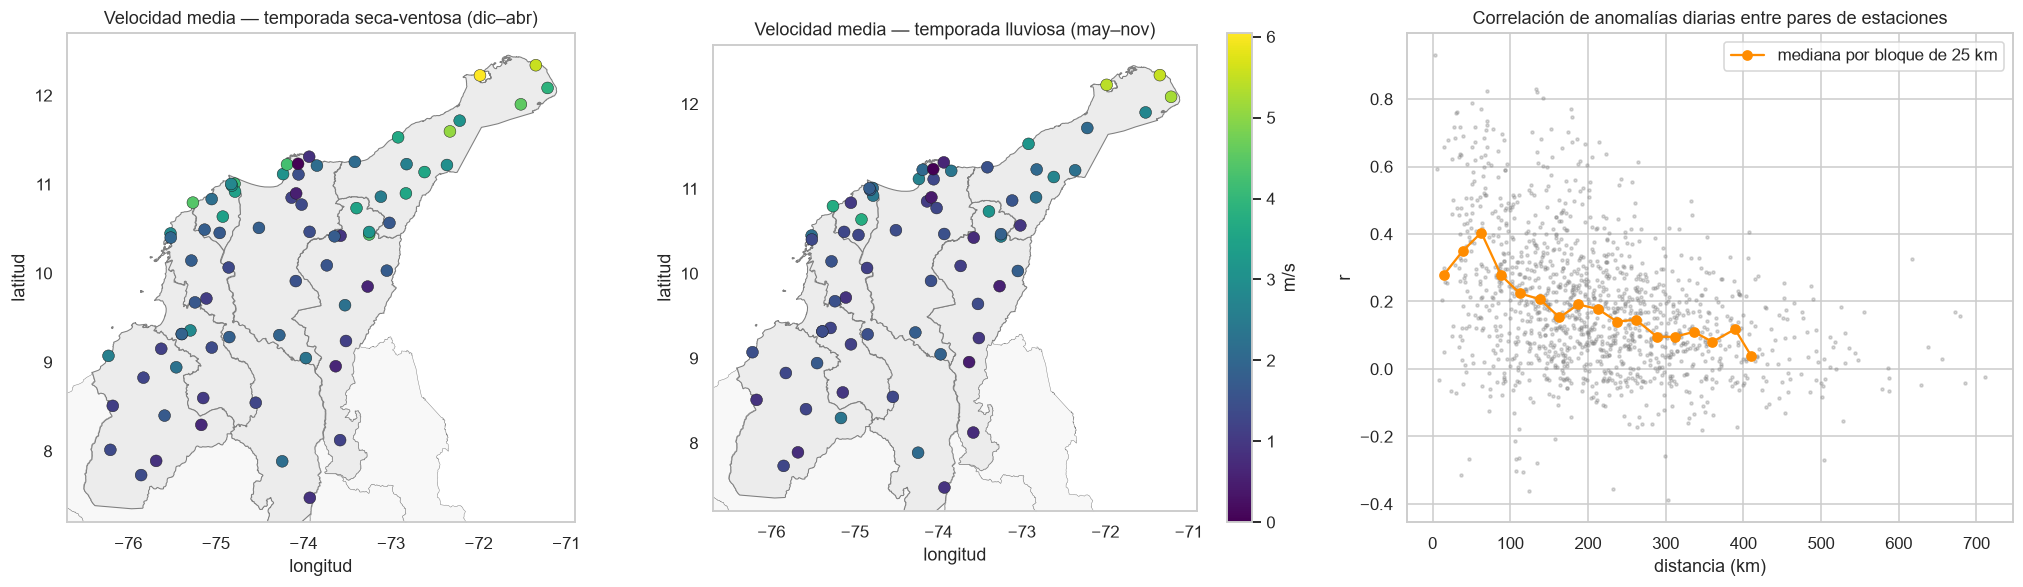
Diseño de la validación. Nuestro objetivo principal es pronosticar el futuro en estaciones conocidas, así
que la validación principal es cronológica. Como objetivo secundario queremos saber cómo generaliza el modelo
a estaciones que no participaron en su ajuste, y eso lo medimos con GroupKFold por estación. Ese escenario
corresponde a una estación nueva de la red que ya tiene su propio historial y vecinos con sensores, no a un
sitio sin mediciones, porque el modelo sigue usando la velocidad pasada de la estación y la de sus vecinos.
Como GroupKFold no garantiza que las estaciones de prueba estén lejos de las de entrenamiento, agregamos un
tercer esquema con bloques geográficos separados por una zona de amortiguación (sección 3.2). Reportamos los
tres esquemas por separado.
El patrón espacial es estable entre temporadas (I de Moran de 0.45 en la seca y de 0.40 en la lluviosa): el
hotspot de La Guajira no se desplaza, solo se intensifica. El 82 % de las estaciones tiene más viento en la
temporada seca (mediana de +0.38 m/s). Las anomalías diarias de estaciones cercanas están correlacionadas
(r ≈ 0.3–0.4 por debajo de 75 km) y la correlación decae con la distancia hasta ≈ 0.1 entre 300 y 400 km,
porque los sistemas meteorológicos afectan a la vez a grupos de estaciones vecinas. Mezclar en el
entrenamiento y en la prueba estaciones vecinas del mismo momento podría filtrar información; con la partición
por años completos ese riesgo no existe.
2.9 Preprocesamiento
Todo lo que se ajusta con datos (el escalado y, si se usara, la transformación del objetivo) va dentro de un
Pipeline que se ajusta solo con el entrenamiento. La tabla relaciona cada decisión con el hallazgo del
análisis exploratorio que la motiva:
| Decisión | Hallazgo del EDA que la motiva |
|---|---|
| Partición cronológica (prueba = 2025) y validación cruzada con pliegues cronológicos | Dependencia temporal fuerte (2.6) |
Validación adicional por estación (GroupKFold) | Autocorrelación espacial y estaciones nuevas cada año (2.7, 2.6.1) |
| Rezagos de velocidad (1, 2, 3, 6, 12, 23 h) y media de 24 h | ACF/PACF con picos en 1 h y 24 h (2.6.3) |
| Hora del objetivo en seno/coseno | Ciclo diario fuerte (2.1, 2.6.3) |
| Día del año en seno/coseno | Ciclo anual: temporada seca-ventosa (2.1, 2.8) |
Componentes u/w en vez de la dirección en grados | La dirección es circular (2.2) |
| Tendencia de presión y cambio/amplitud de temperatura | Correlación cruzada con rezago (2.6.3) |
| Rezago espacial (4 vecinos) | I de Moran y correlación entre estaciones cercanas (2.7, 2.8) |
| Altitud | Diferencias fijas entre estaciones (2.3, 2.4) |
| Casos completos (sin imputación) | Los faltantes son sobre todo estructurales: estaciones sin el sensor (1.6.1) |
| Valores imposibles y sensores defectuosos → NaN o excluidos | Auditoría de calidad (1.6) |
| Sin codificación categórica | La categoría de la estación tiene categorías raras (2.2) y el departamento se asocia sobre todo con la ubicación, que ya entra por la altitud y el rezago espacial (2.3, 2.7) |
| Escalado estándar dentro del Pipeline | El SVR es sensible a la escala; las variables tienen unidades distintas |
| Objetivo sin transformar (el logaritmo se probó en la validación cruzada y empeora el error) | Asimetría positiva del objetivo (2.1) |
| Limpieza causal para el modelado | La depuración del análisis exploratorio usa información de la estación-año completa (1.6) |
3. Modelo base
Como modelo base usamos un SVR lineal (LinearSVR) dentro de un Pipeline con StandardScaler, para
predecir y = vel(t + 24 h) con el pronóstico emitido en t + 1 h (sección 1.1). Con la pérdida cuadrática
insensible a ε y ε = 0, la función de pérdida se reduce al error cuadrático con regularización L2, de modo que
en la práctica se comporta como una regresión lineal regularizada, lo que además conviene por la fuerte
colinealidad entre los rezagos (sección 2.3).
Como referencias simples usamos un DummyRegressor (la media del entrenamiento), la persistencia de 24 h
(vel(t), la misma hora del día anterior al objetivo) y la climatología de cada estación por mes y hora.
Entrenamos con 2020–2024 y evaluamos en 2025, según la partición definida en la sección 2.0.
Datos del modelado: limpieza sin información futura. El análisis exploratorio usa la depuración de la
sección 1.6, que mira la estación-año completa. Para que ninguna etapa del modelado use información del
futuro, en esta sección trabajamos con un panel reprocesado desde los CSV originales con
scripts/procesar_variable_causal.py (procesar_todo.py --causal), en el que cada lectura se limpia solo
con lo ocurrido antes de ella o con metadatos estáticos del catálogo:
| Regla retrospectiva (EDA, secciones 1–2) | Regla causal (modelado, sección 3) |
|---|---|
Excluir la estación-año si > 0.5 % de lecturas anómalas | Enmascarar la lectura si en los 30 días anteriores el sensor tuvo > 0.5 % de lecturas anómalas (mínimo 100 lecturas) |
| Tramo pegado borrado desde su inicio | Se enmascara desde que el tramo cumple el plazo de su variable (6 h; 12 h en presión; 24 h los ceros de velocidad y dirección); las lecturas previas se conservan |
| Picos de presión respecto a la mediana del año | Respecto a la mediana de los 30 días anteriores; sin historial, la presión estándar para la altitud del catálogo |
| Presión frente a la altitud con la mediana del año | Con la mediana de los 30 días anteriores |
| Frecuencia de muestreo estimada con el año completo | Mediana de los 144 intervalos anteriores del sensor; sin historial, la frecuencia nominal del tipo de sensor |
| Sensor con más horas en el año | Si hay varios sensores válidos en la hora, se promedian |
| Nombre y coordenadas de la última observación | De la primera observación |
Las estaciones y los sensores nuevos no se descartan por falta de historial. Mientras un sensor no reúne al menos 100 lecturas en los 30 días anteriores no se lo puede marcar como defectuoso, y solo se le aplica el rango fijo; con sensores de 10 minutos eso ocurre en menos de un día, así que la regla puede empezar a actuar antes de cumplir un mes. Mientras tenga menos de 12 intervalos previos, la frecuencia de muestreo se toma de su tipo de sensor, y sin 3 días previos de presión la referencia es la presión esperada para su altitud.
Como la limpieza es causal en todos los años, tanto los pliegues de validación como la prueba usan datos limpiados solo con su pasado. Las predictoras se construyen con la misma función de la sección 2.0, y la lista de vecinos usa las coordenadas de la primera observación de cada estación. En la sección 3.6 comparamos este procesamiento con el original.
def preparar_panel(ruta):
    # lee un panel estación-hora y construye el conjunto de modelado (mismas predictoras que en 2.0)
    P_ = pd.read_csv(ruta, dtype={"CodigoEstacion": str}, parse_dates=["hora"]).rename(columns={"CodigoEstacion": "est"})
    co = P_.groupby("est")[["lat", "lon"]].first()
    di = haversine_matriz(co.lat.to_numpy(), co.lon.to_numpy())
    np.fill_diagonal(di, np.inf)
    vec = {e: co.index[np.argsort(di[i])[:K_VECINOS]].tolist() for i, e in enumerate(co.index)}
    an = P_.pivot(index="hora", columns="est", values="vel")
    vv = pd.DataFrame({e: an[v].mean(axis=1) for e, v in vec.items()})
    G_ = (P_.set_index("hora").groupby("est")[["vel", "dir_sin", "dir_cos", "dir_constancia", "temp", "pres", "altitud"]]
          .apply(lambda g: g.asfreq("h")))
    todo = G_.groupby(level="est", group_keys=True).apply(construir, vv=vv).reset_index().rename(columns={"hora": "t"})
    return P_, todo, todo.dropna(subset=F_ESP + ["y"]).reset_index(drop=True)


PC, D_todo_c, D_c = preparar_panel(DATOS / "panel_multivariado_causal.csv")
D_o, TR_o, TE_o, D_todo_o = D, TR, TE, D_todo            # procesamiento original (EDA y comparación en 3.6)
D, D_todo = D_c, D_todo_c                                # desde aquí, todo el modelado usa la limpieza causal
TR, TE = D[D.t_y < TEST_INI], D[D.t >= TEST_INI]
completas_c = PC[["vel", "dir", "temp", "pres"]].notna().all(axis=1)
print(f"Panel causal: {len(PC):,} estación-horas con velocidad ({PC.est.nunique()} estaciones); "
      f"{completas_c.sum():,} con las 4 variables")
print(f"Conjunto de modelado causal: {len(D):,} filas | entrenamiento {len(TR):,} | prueba {len(TE):,} "
      f"({TE.est.nunique()} estaciones) | {len(D) - len(TR) - len(TE)} filas de separación en el cambio de año")
Panel causal: 1,308,726 estación-horas con velocidad (76 estaciones); 969,004 con las 4 variables
Conjunto de modelado causal: 616,854 filas | entrenamiento 402,200 | prueba 213,972 (53 estaciones) | 682 filas de separación en el cambio de año
3.1 Validación cruzada temporal en entrenamiento
Elegimos la configuración del modelo con cuatro pliegues cronológicos dentro de 2024. Como los umbrales de
limpieza se fijaron con datos de hasta 2023 (sección 1.6), los datos de validación tienen que ser posteriores.
Cada trimestre de 2024 se valida entrenando con todo lo anterior (2020–2023 y los trimestres previos de 2024),
es decir, con una ventana que crece. Filtrar por la fecha del objetivo (el objetivo de entrenamiento siempre es
anterior al inicio del trimestre) equivale a dejar una separación de 24 h, y el escalado se vuelve a ajustar
dentro del Pipeline en cada entrenamiento. Nos quedamos con la configuración de menor RMSE medio en los
cuatro trimestres.
Como referencia de estabilidad mostramos también pliegues por años completos, con validación en 2021, 2022, 2023 y 2024. No los usamos para elegir, porque los años 2021 a 2023 se conocían cuando fijamos algunos umbrales.
def svr(C=0.1, log=False):
    base = Pipeline([("escalado", StandardScaler()),
                     ("svr", LinearSVR(C=C, epsilon=0.0, loss="squared_epsilon_insensitive", dual=False,
                                       max_iter=20000, random_state=SEED))])
    return TransformedTargetRegressor(regressor=base, func=np.log1p, inverse_func=np.expm1) if log else base


def pliegues(datos):
    for a in range(2021, 2025):
        yield a, datos[datos.t_y < f"{a}-01-01"], datos[(datos.t >= f"{a}-01-01") & (datos.t_y < f"{a + 1}-01-01")]


def pliegues_2024(datos):
    """4 pliegues cronológicos (trimestres de 2024) con ventana de entrenamiento creciente."""
    cortes = pd.to_datetime(["2024-01-01", "2024-04-01", "2024-07-01", "2024-10-01", "2025-01-01"])
    for k in range(4):
        ini, fin = cortes[k], cortes[k + 1]
        yield f"2024-T{k + 1}", datos[datos.t_y < ini], datos[(datos.t >= ini) & (datos.t_y < fin)]


def validar(generador):
    filas = []
    for log in [False, True]:
        for C in [0.01, 0.1, 1.0]:
            for nombre, tr, va in generador(TR):
                rm = np.sqrt(mean_squared_error(va.y, svr(C, log).fit(tr[F_ESP], tr.y).predict(va[F_ESP])))
                filas.append({"log(1+y)": log, "C": C, "pliegue": nombre, "RMSE": rm,
                              "mejora": 1 - rm / np.sqrt(mean_squared_error(va.y, va.vel_l0))})
    r = pd.DataFrame(filas)
    t = r.pivot_table(index=["log(1+y)", "C"], columns="pliegue", values="RMSE")
    t["RMSE medio"] = t.mean(axis=1)
    t["mejora media vs. persistencia"] = r.groupby(["log(1+y)", "C"]).mejora.mean()
    return t


tabla_cv = validar(pliegues_2024)
LOG_OPT, C_OPT = tabla_cv["RMSE medio"].idxmin()
print(f"Configuración elegida (validación cruzada, 4 trimestres de 2024): log(1+y) = {LOG_OPT}, C = {C_OPT}")
display(tabla_cv)
tabla_cv_anual = validar(pliegues)
print("Referencia de estabilidad, pliegues por años completos (no se usan para elegir): "
      f"la configuración de menor RMSE medio sería log(1+y) = {tabla_cv_anual['RMSE medio'].idxmin()[0]}, "
      f"C = {tabla_cv_anual['RMSE medio'].idxmin()[1]}")
tabla_cv_anual
Configuración elegida (validación cruzada, 4 trimestres de 2024): log(1+y) = False, C = 0.01
Referencia de estabilidad, pliegues por años completos (no se usan para elegir): la configuración de menor RMSE medio sería log(1+y) = False, C = 0.01
3.2 Evaluación en el conjunto de prueba (2025)
def bootstrap_dias(y, pred, pers, t, B=1000, bloque=7, rng=np.random.default_rng(SEED)):
    """IC 95 % remuestreando bloques de 7 días (respeta la autocorrelación)."""
    df = pd.DataFrame({"d": pd.to_datetime(t).dt.floor("D").to_numpy(), "y": y, "e": y - pred, "ep": y - pers})
    agg = df.groupby("d").agg(n=("y", "size"), sy=("y", "sum"), sy2=("y", lambda v: (v ** 2).sum()),
                              se=("e", lambda v: (v ** 2).sum()), sa=("e", lambda v: v.abs().sum()),
                              sep=("ep", lambda v: (v ** 2).sum())).to_numpy()
    nb = int(np.ceil(len(agg) / bloque))
    out = []
    for _ in range(B):
        ini = rng.integers(0, len(agg) - bloque + 1, nb)
        n, sy, sy2, se, sa, sep = agg[(ini[:, None] + np.arange(bloque)).ravel()].sum(axis=0)
        out.append([1 - se / (sy2 - sy ** 2 / n), np.sqrt(se / n), sa / n, 1 - np.sqrt(se / sep)])
    return pd.DataFrame(out, columns=["R2", "RMSE", "MAE", "mejora"]).quantile([.025, .975]).T


def metricas(y, pred, pers, grupos):
    rm = np.sqrt(mean_squared_error(y, pred))
    m = y >= 0.5  # MAPE solo con viento ≥ 0.5 m/s: con calma el error porcentual no está definido
    r2e = pd.DataFrame({"g": grupos, "y": y, "p": pred}).groupby("g").apply(lambda d: r2_score(d.y, d.p)).median()
    return {"R2": r2_score(y, pred), "R2 por estación (mediana)": r2e, "RMSE": rm,
            "MAE": mean_absolute_error(y, pred), "MAPE (y ≥ 0.5 m/s, %)": 100 * mean_absolute_percentage_error(y[m], pred[m]),
            "Mejora vs. persistencia": 1 - rm / np.sqrt(mean_squared_error(y, pers))}


y_te, pers_te = TE.y.to_numpy(), TE.vel_l0.to_numpy()
clim = TR.groupby(["est", "mes_y", "hora_y"]).y.mean()
clim_te = clim.reindex(pd.MultiIndex.from_arrays([TE.est, TE.mes_y, TE.hora_y])).to_numpy()
clim_te = np.where(np.isnan(clim_te), TR.y.mean(), clim_te)
modelos = {
    "Dummy (media de train)": DummyRegressor().fit(TR[F_ESP], TR.y).predict(TE[F_ESP]),
    "Persistencia 24 h": pers_te,
    "Climatología estación × mes × hora": clim_te,
}
final = {}
for nombre, F in [("SVR solo velocidad", F_UNI), ("SVR + meteorología", F_MET), ("SVR + meteorología + espacial", F_ESP)]:
    final[nombre] = svr(C_OPT, LOG_OPT).fit(TR[F], TR.y)
    modelos[nombre] = final[nombre].predict(TE[F])
resultados = pd.DataFrame({k: metricas(y_te, v, pers_te, TE.est.to_numpy()) for k, v in modelos.items()}).T
resultadospred_te = modelos["SVR + meteorología + espacial"]
ic = bootstrap_dias(y_te, pred_te, pers_te, TE.t)
ic.columns = ["IC 2.5 %", "IC 97.5 %"]
ic.insert(0, "estimación", [r2_score(y_te, pred_te), np.sqrt(mean_squared_error(y_te, pred_te)),
mean_absolute_error(y_te, pred_te), resultados.loc["SVR + meteorología + espacial", "Mejora vs. persistencia"]])
ic_pers = bootstrap_dias(y_te, pers_te, pers_te, TE.t)
print(f"R² de la persistencia en prueba: IC 95 % [{ic_pers.loc['R2'].iloc[0]:.3f}, {ic_pers.loc['R2'].iloc[1]:.3f}]")
display(ic)
# sensibilidad a la longitud del bloque
sens = pd.DataFrame({f"bloque {b} días": bootstrap_dias(y_te, pred_te, pers_te, TE.t, bloque=b).loc["mejora"]
for b in [3, 7, 14]}).T
sens.columns = ["mejora IC 2.5 %", "mejora IC 97.5 %"]
display(sens)
def diferencia_pareada(y, p_a, p_b, t, B=1000, bloque=7, rng=np.random.default_rng(SEED)):
"""IC 95 % de RMSE(a) − RMSE(b) sobre los mismos bloques de días (comparación pareada)."""
df = pd.DataFrame({"d": pd.to_datetime(t).dt.floor("D").to_numpy(), "ea": (y - p_a) ** 2, "eb": (y - p_b) ** 2})
agg = df.groupby("d").agg(n=("ea", "size"), sa=("ea", "sum"), sb=("eb", "sum")).to_numpy()
nb = int(np.ceil(len(agg) / bloque))
dif = []
for _ in range(B):
ini = rng.integers(0, len(agg) - bloque + 1, nb)
n, sa, sb = agg[(ini[:, None] + np.arange(bloque)).ravel()].sum(axis=0)
dif.append(np.sqrt(sa / n) - np.sqrt(sb / n))
return np.sqrt(np.mean((y - p_a) ** 2)) - np.sqrt(np.mean((y - p_b) ** 2)), *np.percentile(dif, [2.5, 97.5])
pares = [("SVR + meteorología + espacial", "SVR solo velocidad"), ("SVR + meteorología + espacial", "SVR + meteorología"),
("SVR + meteorología", "SVR solo velocidad")]
tabla_pares = pd.DataFrame([dict(zip(["comparación", "ΔRMSE (m/s)", "IC 2.5 %", "IC 97.5 %"],
[f"{a} − {b}", *diferencia_pareada(y_te, modelos[a], modelos[b], TE.t)]))
for a, b in pares]).set_index("comparación")
tabla_pares["¿significativa?"] = np.where((tabla_pares["IC 2.5 %"] > 0) | (tabla_pares["IC 97.5 %"] < 0), "sí", "no")
tabla_paresR² de la persistencia en prueba: IC 95 % [0.614, 0.679]
r2_est = pd.DataFrame({"est": TE.est, "y": y_te, "p": pred_te, "pers": pers_te}).groupby("est").apply(
    lambda d: pd.Series({"R2 SVR": r2_score(d.y, d.p), "R2 persistencia": r2_score(d.y, d.pers), "n": len(d)}))
fig, axs = plt.subplots(1, 2, figsize=(15, 4.5))
axs[0].scatter(r2_est["R2 persistencia"], r2_est["R2 SVR"], s=r2_est.n / r2_est.n.max() * 150 + 10, alpha=.7)
lim = [min(r2_est.min(numeric_only=True)[["R2 SVR", "R2 persistencia"]].min(), -.5), 1]
axs[0].plot(lim, lim, "k--", lw=.8)
axs[0].set(xlabel="R² persistencia", ylabel="R² SVR", title="R² por estación en prueba (2025)", xlim=lim, ylim=lim)
print(f"El SVR supera a la persistencia en {100 * (r2_est['R2 SVR'] > r2_est['R2 persistencia']).mean():.0f} % de las estaciones")

grupos = []
for k, (_, b) in enumerate(GroupKFold(n_splits=5).split(D, groups=D.est)):
    ests_k = set(D.est.iloc[b])
    tr_k, te_k = TR[~TR.est.isin(ests_k)], TE[TE.est.isin(ests_k)]
    if te_k.empty:
        continue
    p_k = svr(C_OPT, LOG_OPT).fit(tr_k[F_ESP], tr_k.y).predict(te_k[F_ESP])
    grupos.append({"pliegue": k + 1, "estaciones de prueba": te_k.est.nunique(), "filas": len(te_k),
                   **metricas(te_k.y.to_numpy(), p_k, te_k.vel_l0.to_numpy(), te_k.est.to_numpy())})
grupos = pd.DataFrame(grupos).set_index("pliegue")
grupos.loc["media"] = grupos.mean()
axs[1].bar(grupos.index[:-1].astype(str), grupos["Mejora vs. persistencia"].iloc[:-1], color="steelblue")
axs[1].set(title="Estaciones no usadas para ajustar (GroupKFold): mejora vs. persistencia", xlabel="pliegue")
fig.tight_layout(); plt.show()
grupos
El SVR supera a la persistencia en 94 % de las estaciones
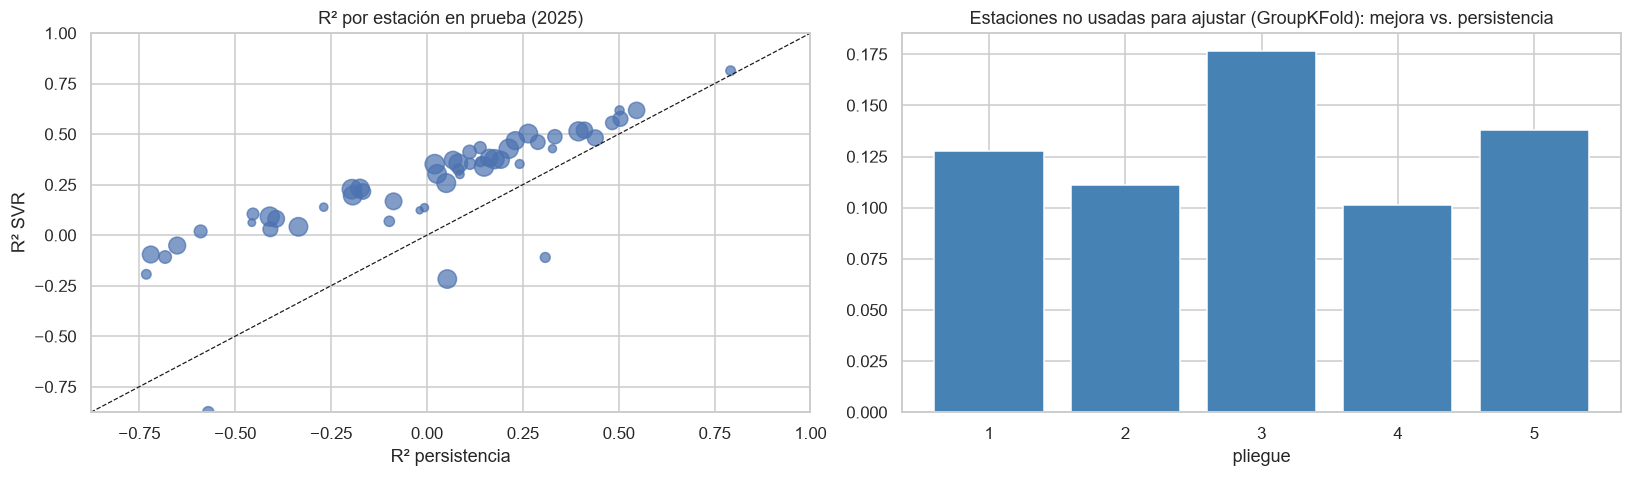
Bloques geográficos con zona de separación. Agrupamos las estaciones en 6 bloques contiguos (k-means sobre
las coordenadas proyectadas). Cada bloque se usa como prueba en 2025, entrenando con 2020–2024 sin las
estaciones del bloque ni las que están a menos de 30 km de alguna de ellas. Como el rezago espacial podría
incluir estaciones del bloque de prueba, en este esquema usamos las predictoras sin rezago espacial (F_MET).
BUFFER_KM = 30
est_mod = est.loc[est.index.isin(D.est.unique())]
xy_mod = np.column_stack([6371 * np.deg2rad(est_mod.lon) * np.cos(lat0), 6371 * np.deg2rad(est_mod.lat)])
bloque = pd.Series(KMeans(6, n_init=20, random_state=SEED).fit_predict(xy_mod), index=est_mod.index)
D_mod = haversine_matriz(est_mod.lat.to_numpy(), est_mod.lon.to_numpy())
filas_b = []
for b in sorted(bloque.unique()):
    en_b = bloque.index[bloque == b]
    cerca = est_mod.index[(D_mod[:, bloque.to_numpy() == b] < BUFFER_KM).any(axis=1)]
    tr_b = TR[~TR.est.isin(set(en_b) | set(cerca))]
    te_b = TE[TE.est.isin(en_b)]
    if te_b.est.nunique() < 2:
        continue
    p_b = svr(C_OPT, LOG_OPT).fit(tr_b[F_MET], tr_b.y).predict(te_b[F_MET])
    filas_b.append({"bloque": b, "estaciones de prueba": te_b.est.nunique(),
                    "excluidas por el buffer": len(set(cerca) - set(en_b)), "filas de prueba": len(te_b),
                    **metricas(te_b.y.to_numpy(), p_b, te_b.vel_l0.to_numpy(), te_b.est.to_numpy())})
bloques = pd.DataFrame(filas_b).set_index("bloque")
bloques.loc["media"] = bloques.mean()
fig, ax = plt.subplots(figsize=(8, 7))
mapa_base(ax)
for b, g in est_mod.groupby(bloque):
    ax.scatter(g.lon, g.lat, s=50, edgecolor="k", lw=.3, label=f"bloque {b}")
ax.set(title="Bloques geográficos para la validación espacial", xlabel="longitud", ylabel="latitud"); ax.legend(fontsize=8)
plt.show()
bloques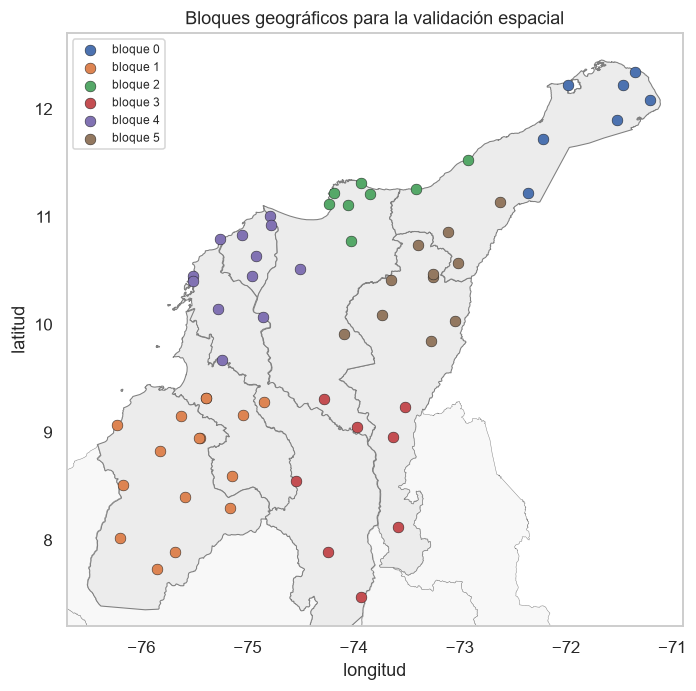
print(f"Predicciones negativas en prueba: {(pred_te < 0).sum()} de {len(pred_te):,} "
      f"({100 * (pred_te < 0).mean():.2f} %); mínimo {pred_te.min():.2f} m/s")
tramos = pd.cut(y_te, [0, 1, 2, 4, 6, np.inf], right=False, labels=["< 1", "1–2", "2–4", "4–6", "≥ 6"])
por_tramo = pd.DataFrame({"y": y_te, "svr": pred_te, "pers": pers_te, "tramo": tramos}).groupby(
    "tramo", observed=True).apply(lambda d: pd.Series({
        "filas": len(d), "RMSE SVR": np.sqrt(np.mean((d.y - d.svr) ** 2)),
        "RMSE persistencia": np.sqrt(np.mean((d.y - d.pers) ** 2)), "sesgo SVR (ŷ − y)": np.mean(d.svr - d.y)}))
por_tramo
Predicciones negativas en prueba: 0 de 213,972 (0.00 %); mínimo 0.05 m/s
Población cubierta. Exigir las cuatro variables deja fuera a las estaciones que no tienen sensor de presión o de temperatura. El modelo que solo usa la velocidad se puede evaluar sobre una población más amplia: todas las filas con los rezagos de velocidad completos.
D_vel = D_todo.dropna(subset=F_UNI + ["y"])
TR_v, TE_v = D_vel[D_vel.t_y < TEST_INI], D_vel[D_vel.t >= TEST_INI]
p_v = svr(C_OPT, LOG_OPT).fit(TR_v[F_UNI], TR_v.y).predict(TE_v[F_UNI])
cobertura = pd.DataFrame({
    "filas de prueba": [len(TE), len(TE_v)], "estaciones de prueba": [TE.est.nunique(), TE_v.est.nunique()],
    **{k: [resultados.loc["SVR solo velocidad", k], v] for k, v in
       metricas(TE_v.y.to_numpy(), p_v, TE_v.vel_l0.to_numpy(), TE_v.est.to_numpy()).items()}},
    index=["SVR solo velocidad, casos completos (4 variables)", "SVR solo velocidad, todas las filas con velocidad"])
cobertura3.3 Diagnóstico de residuos
res = pd.DataFrame({"est": TE.est.to_numpy(), "t": TE.t.to_numpy(), "pred": pred_te, "res": y_te - pred_te})
fig, axs = plt.subplots(1, 3, figsize=(17, 4.5))
sns.histplot(res.res, bins=100, ax=axs[0], color="steelblue")
axs[0].set(title="Distribución de residuos", xlabel="y − ŷ (m/s)")
stats.probplot(muestra(res.res, 20000), dist="norm", plot=axs[1])
axs[1].set_title("QQ-plot de residuos")
axs[2].hexbin(res.pred, res.res, gridsize=60, bins="log", cmap="viridis", mincnt=1)
axs[2].axhline(0, c="r", lw=.8)
axs[2].set(title="Residuos vs. predicción", xlabel="ŷ (m/s)", ylabel="residuo")
fig.tight_layout(); plt.show()
mb = muestra(res, 20000)
bp = het_breuschpagan(mb.res, np.column_stack([np.ones(len(mb)), mb.pred]))
print(f"Asimetría: {stats.skew(res.res):.2f} | curtosis: {stats.kurtosis(res.res):.2f} | "
      f"Breusch-Pagan: LM = {bp[0]:.0f}, p = {bp[1]:.2g}")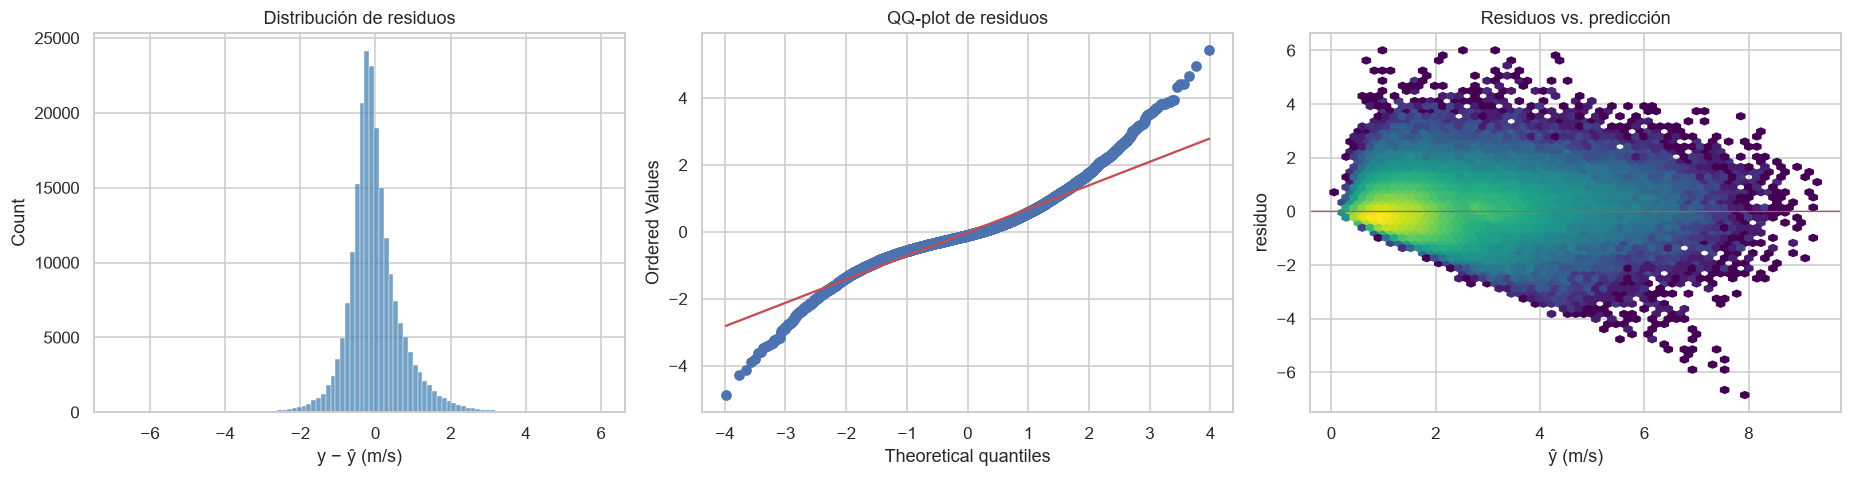
Asimetría: 0.73 | curtosis: 4.02 | Breusch-Pagan: LM = 1892, p = 0
acf_est = []
for e_, g in res.groupby("est"):
    s = g.set_index("t").res.asfreq("h")
    if s.notna().sum() > 500:
        acf_est.append(acf(s, nlags=48, missing="conservative"))
acf_m = np.mean(acf_est, axis=0)

dias = res.assign(d=res.t.dt.floor("D")).groupby(["d", "est"]).res.mean().reset_index()
I_dia = []
for d_, g in dias.groupby("d"):
    if len(g) < 10:
        continue
    c = est.loc[g.est, ["lat", "lon"]]
    Wd = pesos_knn(haversine_matriz(c.lat.to_numpy(), c.lon.to_numpy()))
    I_dia.append(moran_perm(g.res.to_numpy(), Wd, n=99))
I_dia = np.array(I_dia)
em = res.groupby("est").res.mean()
I_est, p_est = moran_perm(em.to_numpy(), pesos_knn(haversine_matriz(est.loc[em.index, "lat"].to_numpy(),
                                                                     est.loc[em.index, "lon"].to_numpy())))
fig, axs = plt.subplots(1, 2, figsize=(15, 4))
axs[0].bar(range(49), acf_m, color="steelblue")
axs[0].axhspan(-1.96 / np.sqrt(len(res) / len(acf_est)), 1.96 / np.sqrt(len(res) / len(acf_est)), color="gray", alpha=.3)
axs[0].set(title="ACF media de los residuos por estación", xlabel="rezago (h)")
axs[1].hist(I_dia[:, 0], bins=30, color="steelblue")
axs[1].set(title="I de Moran diario de los residuos (2025)", xlabel="I")
fig.tight_layout(); plt.show()
print(f"ACF de residuos: rezago 1 = {acf_m[1]:.2f}, rezago 24 = {acf_m[24]:.2f}")
print(f"I de Moran diario: media {I_dia[:, 0].mean():.3f}; significativo (p < 0.05) en {100 * (I_dia[:, 1] < .05).mean():.0f} % de los días")
print(f"I de Moran del residuo medio por estación: {I_est:.3f} (p = {p_est:.3f})")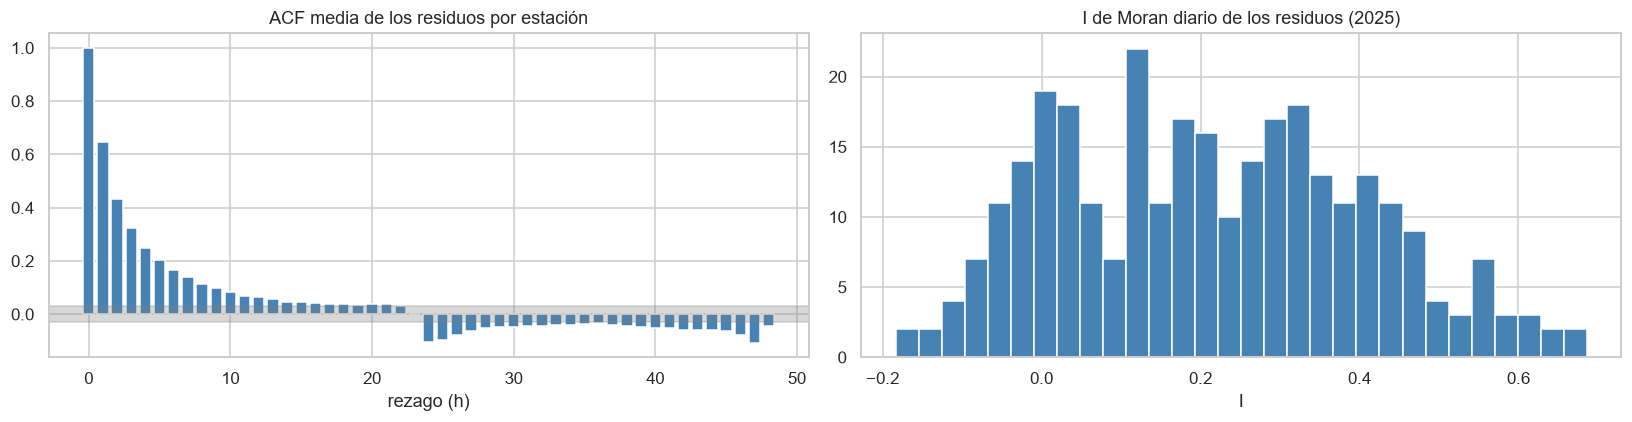
ACF de residuos: rezago 1 = 0.65, rezago 24 = -0.10
I de Moran diario: media 0.212; significativo (p < 0.05) en 55 % de los días
I de Moran del residuo medio por estación: 0.286 (p = 0.002)
3.4 Curva de aprendizaje
Entrenamos con fracciones crecientes de 2020–2023, empezando por los datos más recientes, y evaluamos siempre en 2024, sin tocar la prueba.
base_lc, val_lc = TR[TR.t_y < "2024-01-01"], TR[TR.t >= "2024-01-01"]
fechas = np.sort(base_lc.t.unique())
lc = []
for frac in [.05, .1, .2, .4, .6, .8, 1.0]:
    sub = base_lc[base_lc.t >= fechas[int(len(fechas) * (1 - frac))]]
    mod = svr(C_OPT, LOG_OPT).fit(sub[F_ESP], sub.y)
    lc.append({"filas de entrenamiento": len(sub),
               "RMSE train": np.sqrt(mean_squared_error(sub.y, mod.predict(sub[F_ESP]))),
               "RMSE validación 2024": np.sqrt(mean_squared_error(val_lc.y, mod.predict(val_lc[F_ESP])))})
lc = pd.DataFrame(lc)
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(lc["filas de entrenamiento"], lc["RMSE train"], "o-", label="entrenamiento")
ax.plot(lc["filas de entrenamiento"], lc["RMSE validación 2024"], "s-", label="validación 2024")
ax.set(xscale="log", xlabel="filas de entrenamiento (escala log)", ylabel="RMSE (m/s)", title="Curva de aprendizaje")
ax.legend(); plt.show()
lc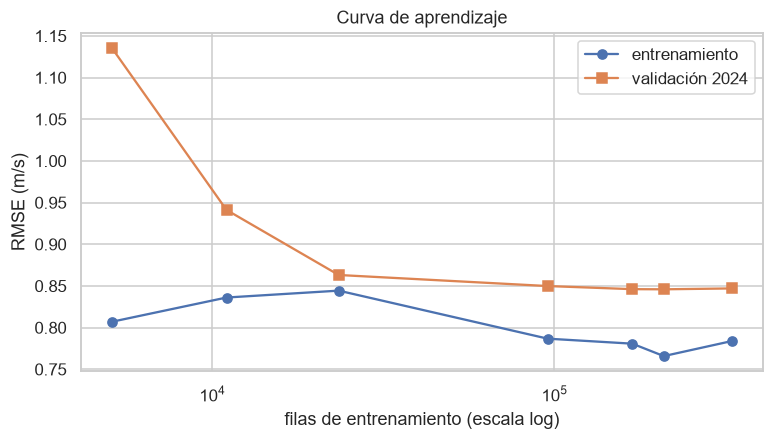
3.5 Interpretación de coeficientes
reg = final["SVR + meteorología + espacial"]
svr_fit = reg.regressor_.named_steps["svr"] if LOG_OPT else reg.named_steps["svr"]
coef = pd.Series(svr_fit.coef_, index=F_ESP).sort_values(key=np.abs, ascending=False)
fig, ax = plt.subplots(figsize=(9, 7))
coef.iloc[::-1].plot.barh(ax=ax, color=np.where(coef.iloc[::-1] > 0, "steelblue", "indianred"))
ax.set(title="Coeficientes estandarizados del SVR final" + (" (escala log(1+y))" if LOG_OPT else ""),
       xlabel="coeficiente")
plt.show()
coef.to_frame("coeficiente").T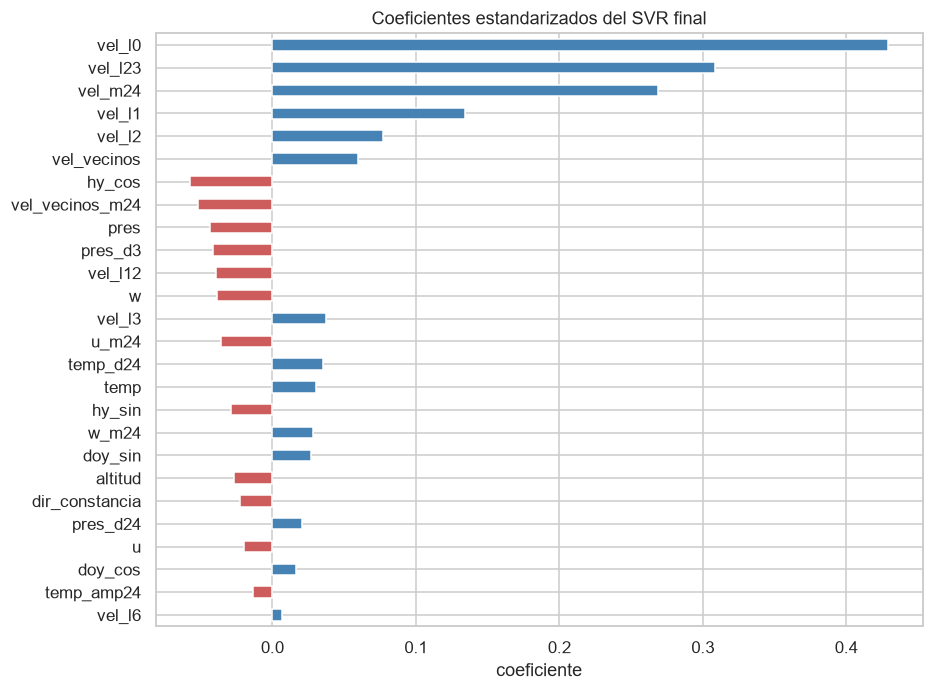
Todos los resultados de esta sección usan la limpieza causal.
La configuración elegida con los cuatro trimestres de 2024 es la misma que se obtendría con los pliegues por
años. El parámetro C no cambia el resultado, porque con unas 400 000 filas la regularización pesa muy poco.
Transformar el objetivo con
log(1 + y) empeora mucho el error: en los trimestres de 2024 la mejora media sobre la persistencia es de
−0.2 %, frente a 12.8 % sin transformar, porque al volver a m/s con la exponencial los errores se amplifican.
Por eso usamos el objetivo en su escala original.
En la prueba de 2025, el SVR completo obtiene R² = 0.737 (IC 95 %: 0.713–0.756) y RMSE = 0.733 m/s
(0.710–0.758 m/s), frente a R² = 0.651 (0.614–0.679) de la persistencia. Es decir, reduce el error de la
persistencia en un 13.2 % (IC 95 %: 12.2–14.4 %), y ese resultado se mantiene con bloques de 3, 7 o 14 días en
el bootstrap. Mejora a la persistencia en el 94 % de las estaciones, y la climatología y el modelo de la media
quedan muy por detrás.
En estaciones que no participaron en el ajuste (GroupKFold) la mejora media es del 13 %, con un R² medio de
0.65 entre pliegues. Con bloques geográficos separados por 30 km, y sin rezago espacial, la mejora media es del
12 % y es positiva en los seis bloques, entre el 6 % y el 17 %. El promedio de los R² de los bloques, que no es
un R² calculado con todas las predicciones juntas, es de 0.57 y varía mucho de una región a otra (entre 0.30 y
0.73).
Casi toda la mejora viene de la historia de la velocidad (+12.3 %). En la comparación pareada con bootstrap, las
variables meteorológicas reducen el RMSE en 0.007 m/s (IC 95 %: 0.006–0.008) y el rezago espacial en 0.001 m/s
(0.001–0.002): diferencias que se distinguen de cero pero que en la práctica son despreciables. Los coeficientes
respaldan este resultado: los mayores son la velocidad actual (0.43), la de hace 23 h (0.31) y la media de las últimas
24 h (0.27). En esencia, el modelo estima el viento de mañana a esta hora combinando el de hoy a la misma hora
con el nivel general del día.
No hay predicciones negativas. El SVR mejora a la persistencia en todos los tramos por debajo de 6 m/s, pero con
vientos fuertes (≥ 6 m/s, el 2 % de las horas) es peor que ella (RMSE de 1.75 m/s frente a 1.59 m/s) y los subestima
en 1.3 m/s de media: el modelo lineal tiende hacia la media. Es una limitación importante para aplicaciones
eólicas.
Al evaluar el modelo de solo velocidad sobre todas las filas con velocidad (310 027 filas y 65 estaciones en
2025, frente a 213 972 y 53 con las cuatro variables) se obtienen resultados agregados similares (R² = 0.74 y
una mejora del 12 %), aunque eso no descarta diferencias en subgrupos concretos.
Los residuos tienen asimetría positiva y colas pesadas (curtosis de 4.0), son heterocedásticos (Breusch-Pagan,
p ≈ 0: el error crece con la velocidad predicha), están fuertemente autocorrelacionados de una hora a la
siguiente (0.65) y también en el espacio (I de Moran de 0.29 para el residuo medio por estación, significativo
en el 55 % de los días). Queda estructura temporal y espacial que el modelo lineal no captura.
En la curva de aprendizaje, el error de validación deja de bajar a partir de unas 95 000 filas y el de entrenamiento no disminuye, lo que sugiere un sesgo alto, es decir, un modelo demasiado simple más que falta de datos. Hay que tomarlo con cautela, porque al ampliar la ventana cambian a la vez la cantidad de datos, los años y las estaciones incluidas.
3.6 Comparación con el procesamiento original y con el criterio alternativo de temperatura
Ajustamos el mismo modelo, con la misma configuración, sobre el panel de la depuración original y lo comparamos con el principal. Primero mostramos cada evaluación con su propia población de prueba, y después solo las observaciones comunes (misma estación, hora y valor objetivo), para distinguir un cambio de desempeño de un cambio en la población evaluada.
pred_o = svr(C_OPT, LOG_OPT).fit(TR_o[F_ESP], TR_o.y).predict(TE_o[F_ESP])
comp = pd.DataFrame({
    "original (depuración retrospectiva)": {"filas de prueba": len(TE_o), "estaciones de prueba": TE_o.est.nunique(),
                                            **metricas(TE_o.y.to_numpy(), pred_o, TE_o.vel_l0.to_numpy(), TE_o.est.to_numpy())},
    "causal (principal)": {"filas de prueba": len(TE), "estaciones de prueba": TE.est.nunique(),
                           **metricas(y_te, pred_te, pers_te, TE.est.to_numpy())},
}).T
display(comp)


def comparar_comunes(TE_a, pred_a, TE_b, pred_b, nombre_a, nombre_b):
    a = TE_a[["est", "t", "y", "vel_l0"]].assign(pred=pred_a)
    b = TE_b[["est", "t", "y", "vel_l0"]].assign(pred=pred_b)
    com = a.merge(b, on=["est", "t"], suffixes=("_a", "_b"))
    igual = np.isclose(com.y_a, com.y_b, atol=1e-6)
    print(f"Filas comunes: {len(com):,} ({100 * len(com) / len(TE_a):.1f} % de {nombre_a} y "
          f"{100 * len(com) / len(TE_b):.1f} % de {nombre_b}); con el mismo objetivo: {100 * igual.mean():.1f} %")
    cm = com[igual]
    dif, lo_, hi_ = diferencia_pareada(cm.y_b.to_numpy(), cm.pred_b.to_numpy(), cm.pred_a.to_numpy(), cm.t)
    print(f"Sobre esas {len(cm):,} filas: RMSE({nombre_b}) − RMSE({nombre_a}) = {dif:+.4f} m/s "
          f"(IC 95 %: {lo_:+.4f} a {hi_:+.4f})")
    return pd.DataFrame({
        nombre_a: metricas(cm.y_a.to_numpy(), cm.pred_a.to_numpy(), cm.vel_l0_a.to_numpy(), cm.est.to_numpy()),
        nombre_b: metricas(cm.y_b.to_numpy(), cm.pred_b.to_numpy(), cm.vel_l0_b.to_numpy(), cm.est.to_numpy())}).T


comparar_comunes(TE_o, pred_o, TE, pred_te, "original", "causal")Filas comunes: 209,506 (99.4 % de original y 97.9 % de causal); con el mismo objetivo: 86.3 %
Sobre esas 180,779 filas: RMSE(causal) − RMSE(original) = -0.0002 m/s (IC 95 %: -0.0003 a -0.0001)
Criterio alternativo de temperatura. El modelado usa el criterio general de sensor defectuoso, fijado antes
de conocer 2025 (cualquier lectura fuera de [3, 45] °C). Como prueba de sensibilidad reprocesamos la
temperatura con el criterio de la depuración original, que se adoptó después de ver 2025 (contar solo las
lecturas por encima de 45 °C), y repetimos el ajuste y la prueba.
_, _, D_alt = preparar_panel(DATOS / "panel_multivariado_causal_temp_alt.csv")
TR_alt, TE_alt = D_alt[D_alt.t_y < TEST_INI], D_alt[D_alt.t >= TEST_INI]
pred_alt = svr(C_OPT, LOG_OPT).fit(TR_alt[F_ESP], TR_alt.y).predict(TE_alt[F_ESP])
display(pd.DataFrame({
    "causal, temperatura: fuera de [3, 45] °C, fijado antes de 2025 (principal)": {
        "filas de prueba": len(TE), "estaciones de prueba": TE.est.nunique(),
        **metricas(y_te, pred_te, pers_te, TE.est.to_numpy())},
    "causal, temperatura: solo > 45 °C, fijado viendo 2025": {
        "filas de prueba": len(TE_alt), "estaciones de prueba": TE_alt.est.nunique(),
        **metricas(TE_alt.y.to_numpy(), pred_alt, TE_alt.vel_l0.to_numpy(), TE_alt.est.to_numpy())},
}).T)
comparar_comunes(TE_alt, pred_alt, TE, pred_te, "criterio fijado viendo 2025", "criterio principal")Filas comunes: 213,972 (99.2 % de criterio fijado viendo 2025 y 100.0 % de criterio principal); con el mismo objetivo: 100.0 %
Sobre esas 213,972 filas: RMSE(criterio principal) − RMSE(criterio fijado viendo 2025) = -0.0002 m/s (IC 95 %: -0.0003 a -0.0001)
La limpieza causal evalúa 213 972 filas en 53 estaciones, frente a 210 859 en 51 con la original, porque ya no
excluye estación-años completos, enmascara los tramos pegados solo desde que cumplen su plazo y promedia los
sensores. Las métricas agregadas son casi iguales (R² = 0.737 frente a 0.739, con la misma mejora del 13.2 %).
Sobre las 180 779 observaciones comunes con el mismo valor objetivo, la diferencia de RMSE es de −0.0002 m/s
(IC 95 %: −0.0003 a −0.0001): distinguible de cero, pero de un tamaño despreciable. No encontramos, por tanto,
una diferencia apreciable entre los dos procesamientos, y la pequeña diferencia en el R² agregado se explica por
el cambio en la población evaluada. Con el criterio de temperatura adoptado después de ver 2025 las métricas son
prácticamente idénticas (diferencia de RMSE de 0.0002 m/s sobre las mismas 213 972 filas), de modo que esa
decisión no influye en los resultados que reportamos.
3.7 Robustez y alcance de los resultados
Un R² moderado no basta para descartar una fuga; lo que la descarta son la auditoría de las predictoras (2.5),
la limpieza causal (3.6) y una partición que respeta el tiempo y se complementa con la validación por estación y
por bloques geográficos (3.2). Lo que aporta el modelo es la reducción del error frente a la persistencia (3.5),
no el valor absoluto del R², porque parte del R² global se debe a las diferencias fijas entre estaciones. El
R² mediano por estación, entre 0.32 y 0.34, es la medida más fiel de lo que el modelo realmente pronostica,
y deja un margen claro para mejorar.
4. Conclusiones y limitaciones
A partir de 30 millones de lecturas crudas del IDEAM construimos un panel horario de 1.3 millones de estación-horas en 76 estaciones del Caribe colombiano (2020–2025), de las cuales 961 860 tienen las cuatro variables (63 estaciones). Documentamos la auditoría de calidad y comprobamos que la presión es coherente con la altitud del catálogo.
El viento de la región tiene ciclos diario y anual fuertes, un gradiente espacial marcado, con un hotspot en La Guajira, y una dependencia temporal y espacial que obliga a validar por periodos y por estación.
Con una limpieza que no usa información futura, el SVR lineal pronostica la velocidad a 24 h con
R² = 0.737y reduce el error de la persistencia en un13.2 %(sección 3.5); la mejora se mantiene en estaciones que no participaron en el ajuste y en bloques geográficos separados. Las variables meteorológicas aportan poco a un modelo lineal, aunque su información mutua con el objetivo sugiere relaciones no lineales.Los residuos conservan estructura temporal, espacial y heterocedástica, y la curva de aprendizaje apunta a un sesgo alto. El paso siguiente es probar modelos no lineales (árboles y boosting) capaces de aprovechar interacciones como la de la dirección con la hora del día en la brisa marina.
Limitaciones. Los datos son crudos y no están validados por el IDEAM. La red cambia de un año a otro y está
sesgada hacia las tierras bajas. Trabajamos con casos completos, así que quedan fuera las estaciones sin sensor
de presión o de temperatura. El R² global depende del conjunto de estaciones de cada año, por lo que siempre lo
acompañamos del R² por estación y de la mejora sobre la persistencia. El análisis exploratorio usa una
depuración retrospectiva (1.6), distinta de la limpieza causal del modelado. La hora local es un supuesto que
respalda el ciclo diario, pero la fuente no la documenta. Por último, la anticipación real desde que se emite el pronóstico es de
23 h hasta el inicio de la hora objetivo.
import sklearn, scipy, statsmodels, matplotlib
print("Versiones:", {m.__name__: m.__version__ for m in [np, pd, sklearn, scipy, statsmodels, matplotlib, sns]},
      "| semilla:", SEED)
Versiones: {'numpy': '2.4.6', 'pandas': '3.0.6', 'sklearn': '1.9.1', 'scipy': '1.17.1', 'statsmodels': '0.15.0', 'matplotlib': '3.11.2', 'seaborn': '0.13.2'} | semilla: 42